Microsoft y Nvidia impulsan una nueva categoría de ordenadores con superchips de inferencia local de IA
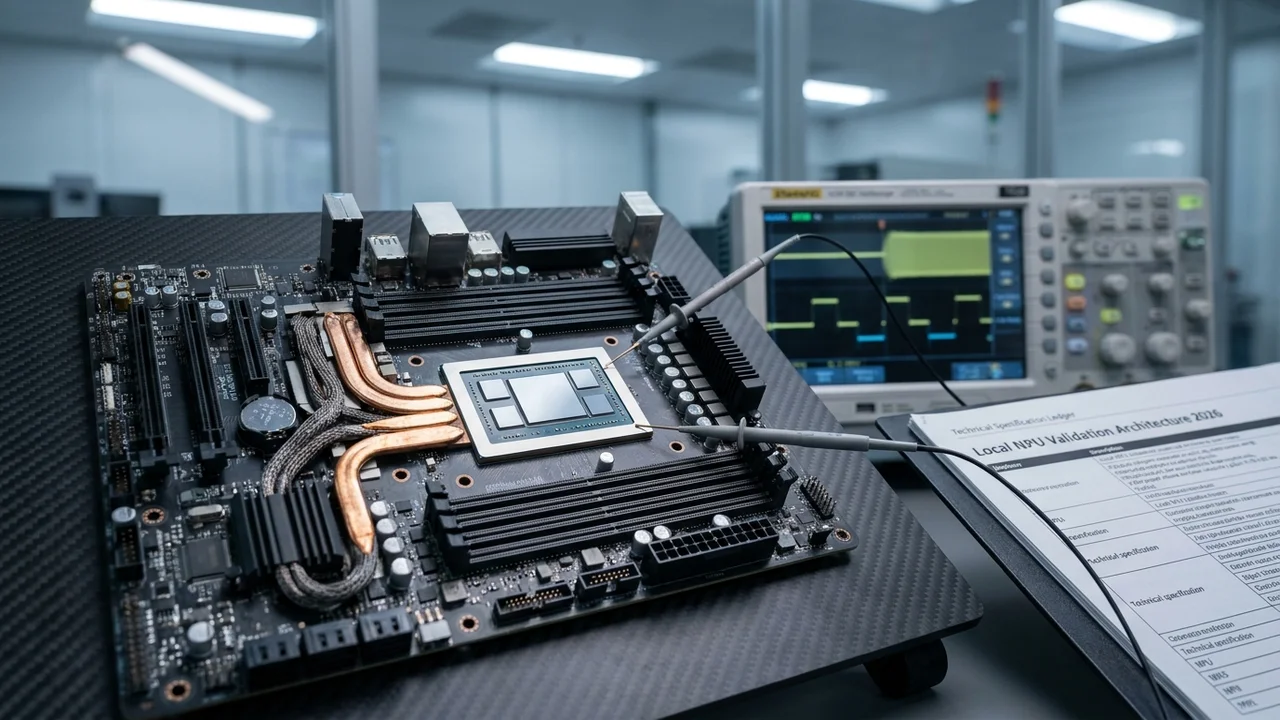
En una alianza estratégica que marca el inicio de una nueva era para la informática personal e industrial, Microsoft y Nvidia han presentado formalmente una categoría inédita de ordenadores personales de IA equipados con el superchip RTX Spark. Esta arquitectura revolucionaria rompe el histórico cuello de botella de la memoria mediante un bus unificado coherente que enlaza la CPU central con módulos tensoriales masivos, permitiendo ejecutar modelos fundacionales de más de 70.000 millones de parámetros (70B) de forma íntegramente local, sin conexión a Internet y con latencias de inferencia inferiores a 10 milisegundos. El anuncio transforma radicalmente el panorama del cómputo empresarial al transferir la potencia de los centros de datos hiperescalares directamente al escritorio y a las plantas industriales.
1. El Fin del Paradigma Dependiente de la Nube: La Revolución del RTX Spark
Durante los últimos cuatro años, la revolución de la inteligencia artificial generativa estuvo atada de forma casi exclusiva a las arquitecturas centralizadas de nube pública. Cada consulta, resumen o generación de código dependía de llamadas API a infraestructuras remotas, acarreando costos recurrentes por millón de tokens, problemas de congestión de red y graves reservas en torno a la soberanía de los datos corporativos. Sin embargo, tal como reporta Notimérica y amplían los análisis de ingeniería en el Nvidia Technical Blog, la alianza entre Redmond y Santa Clara inaugura el hardware de inferencia local definitiva.
El superchip RTX Spark integra en un encapsulado único una CPU multinúcleo de arquitectura ARM de ultrabajo consumo, un clúster de núcleos Tensor de arquitectura Blackwell optimizada y hasta 128 GB de memoria unificada LPDDR5X-Ultra con un ancho de banda superior a 1,2 TB/s. Esta topología elimina las transferencias redundantes a través del bus PCIe tradicional, que hasta ahora limitaba severamente el rendimiento de las tarjetas gráficas dedicadas de consumo cuando los pesos de los modelos superaban la capacidad de la VRAM aislada.
Microsoft, por su parte, ha reconstruido la capa de subsistema de Windows 11 para integrar de manera nativa DirectML y Windows Copilot Runtime con el silicio de Nvidia, permitiendo que cualquier aplicación de escritorio orqueste agentes locales con permisos de archivo granulares y cero filtración de telemetría hacia el exterior.
"Estamos ante el mayor cambio de paradigma en la computación de consumo desde la llegada de la GPU programable. La categoría de ordenadores impulsados por el superchip RTX Spark democratiza el razonamiento algorítmico profundo: cada empresa, científico, desarrollador y creador puede ahora albergar un modelo de frontera de 70 mil millones de parámetros en su escritorio físico, operando con absoluta privacidad, determinismo temporal y sin factura mensual de nube por consumo de tokens."
2. Radiografía Técnica: Memoria Unificada de Coherencia Total y Cuantización FP4 Nativa
El salto cualitativo del sistema no se fundamenta únicamente en la miniaturización litográfica, sino en una transformación integral del flujo de datos en el silicio:
- Topología de Memoria de Coherencia Caché Unificada (NVLink-C2C): Al interconectar la CPU y la GPU mediante un puente de silicio de ultra-alta velocidad, el sistema operativo no requiere duplicar los buffers en la RAM del sistema y la VRAM del acelerador. Los pesos del modelo residen en un espacio de direccionamiento virtual único accesible instantáneamente por ambos motores.
- Soporte Nativo de Precisión Microescalar FP4 y FP8: La unidad tensorial del RTX Spark incorpora instrucciones de cálculo en punto flotante de 4 bits (FP4) que reducen el tamaño en memoria de un modelo de 70B de aproximadamente 140 GB a tan solo 35 GB, preservando más del 99,2% de la precisión semántica y de razonamiento matemático del modelo base sin incurrir en degradación de perplejidad.
- Latencia First-Token Sub-10ms y Rendimiento Sostenido: El subsistema entrega velocidades de generación sostenidas de más de 45 tokens por segundo para modelos de 70B y hasta 120 tokens por segundo para modelos de destilación de 8B, superando con creces la velocidad de respuesta de las APIs en la nube sometidas al jitter y enrutamiento transoceánico.
- Eficiencia Térmica y Envolvente Energética (TDP): Diseñado para estaciones de trabajo compactas y portátiles para ingenieros, el chip opera en rangos configurables de entre 45W y 120W, prescindiendo de los complejos sistemas de refrigeración líquida que demandaban los nodos de servidor equivalentes.
Windows Copilot Runtime con Seguridad Hardware-Rooted
Para blindar las operaciones locales, Microsoft incorporó el módulo de seguridad Microsoft Pluton directamente en la matriz del RTX Spark. Todas las bases de conocimiento locales (vector databases integradas en SQLite o LanceDB) están cifradas con llaves atadas al hardware, asegurando que los embeddings empresariales permanezcan inaccesibles incluso en caso de robo físico de la máquina.
3. Análisis FinOps, Transición CapEx vs. OpEx y Amortización Financiera
La introducción de estaciones de trabajo con superchips de inferencia local redefine la ecuación económica de la tecnología en las corporaciones:
- Deuda Operativa de Nube (OpEx) vs. Inversión en Activo Fijo (CapEx): Mantener un equipo de 20 ingenieros consumiendo APIs de modelos de lenguaje de última generación en la nube genera un gasto operativo de entre USD 12.000 y USD 35.000 mensuales en tokens de inferencia. Una flota de ordenadores equipados con RTX Spark (con un costo unitario estimado en USD 3.200) amortiza su inversión total en menos de cinco meses de uso intensivo.
- Eliminación de Costos Ocultos de Egress y Almacenamiento Vectorial: Al indexar millones de documentos internos en el almacenamiento NVMe Gen5 local, las organizaciones eliminan los costos de transferencia saliente de datos (egress fees) y las costosas suscripciones a bases de datos vectoriales gestionadas en la nube.
- Garantía de Continuidad de Negocio frente a Caídas de Proveedores: Las operaciones críticas de auditoría, soporte de código, diseño de ingeniería y diagnóstico médico local continúan ejecutándose al 100% de capacidad operativa durante caídas de infraestructura de hiperescalares o cortes de enlaces de fibra óptica submarina.
4. Oportunidades y Desafíos Estratégicos para Empresas de Argentina y América Latina
Para el tejido empresarial de América Latina y especialmente para las compañías argentinas, el lanzamiento de estaciones con inferencia local de IA representa una disrupción altamente ventajosa:
- Cobertura Frente a la Restricción de Divisas y Variabilidad Cambiaria: Pagar suscripciones mensuales recurrentes en dólares por consumo de APIs en la nube representa una vulnerabilidad operativa severa para las PyMEs argentinas. La adquisición de hardware físico como inversión de capital amortizable permite fijar costos en pesos o activos tangibles, blindando las finanzas corporativas contra devaluaciones imprevistas.
- Soberanía de Datos y Secreto Profesional: Estudios jurídicos, consultoras contables, laboratorios farmacéuticos y entidades bancarias de la región suelen verse impedidos de utilizar herramientas de IA en la nube debido a leyes locales de protección de datos (como la Ley 25.326 en Argentina). Los ordenadores con RTX Spark permiten procesar datos hiperconfidenciales en local con total cumplimiento legal.
- Infraestructura Resistente a la Conectividad Inestable: En zonas industriales, plantas agropecuarias, explotaciones mineras o cuencas petroleras (como Vaca Muerta), donde la conectividad satelital o de fibra es costosa o intermitente, desplegar agentes de IA de 70B en el borde permite diagnósticos predictivos y automatización operativa sin latencia ni dependencia de enlaces externos.
5. Hoja de Ruta de Implementación para CIOs, CISOs y Gerentes de TI
Para planificar la adopción ordenada de esta nueva clase de ordenadores de inferencia local, las organizaciones deben seguir las siguientes fases de despliegue:
- Realizar un Censo de Cargas de Trabajo y Consumo de Tokens API: Auditar los gastos mensuales actuales en servicios de IA en la nube, identificando qué equipos (desarrollo, análisis financiero, redacción técnica) consumen mayores volúmenes de inferencia y se beneficiarían de migrar a estaciones de trabajo locales.
- Seleccionar Modelos Fundacionales Abiertos Cuantizados (Open Weights): Estandarizar la biblioteca corporativa en pesos abiertos de alta eficiencia (como Llama 3.3, Mistral Large o DeepSeek Coder) optimizados para formatos FP4 y cuantizaciones GGUF/TensorRT-LLM compatibles con RTX Spark.
- Implementar un Bus Local de Model Context Protocol (MCP): Configurar el entorno de escritorio para que los modelos locales interactúen de forma segura con bases de datos internas, repositorios Git y sistemas ERP locales a través del protocolo estandarizado MCP con auditoría de privilegios.
- Establecer Protocolos de Respaldo y Gobernanza de Pesos de IA: Diseñar mecanismos centralizados para la distribución y actualización periódica de los pesos de los modelos hacia la flota de ordenadores locales, garantizando que todos los colaboradores operen con versiones alineadas, seguras y libres de sesgos no supervisados.
Fuentes & Referencias Verificadas
¿Querés integrar hardware especializado o robótica en tus operaciones?
En Siglo 21 Soluciones asesoramos en despliegue de silicio de inferencia local, automatización robótica y sensores IoT industriales.
Contactar a un Consultor