La escasez global de memorias HBM4 reconfigura las cadenas de suministro de hardware de IA
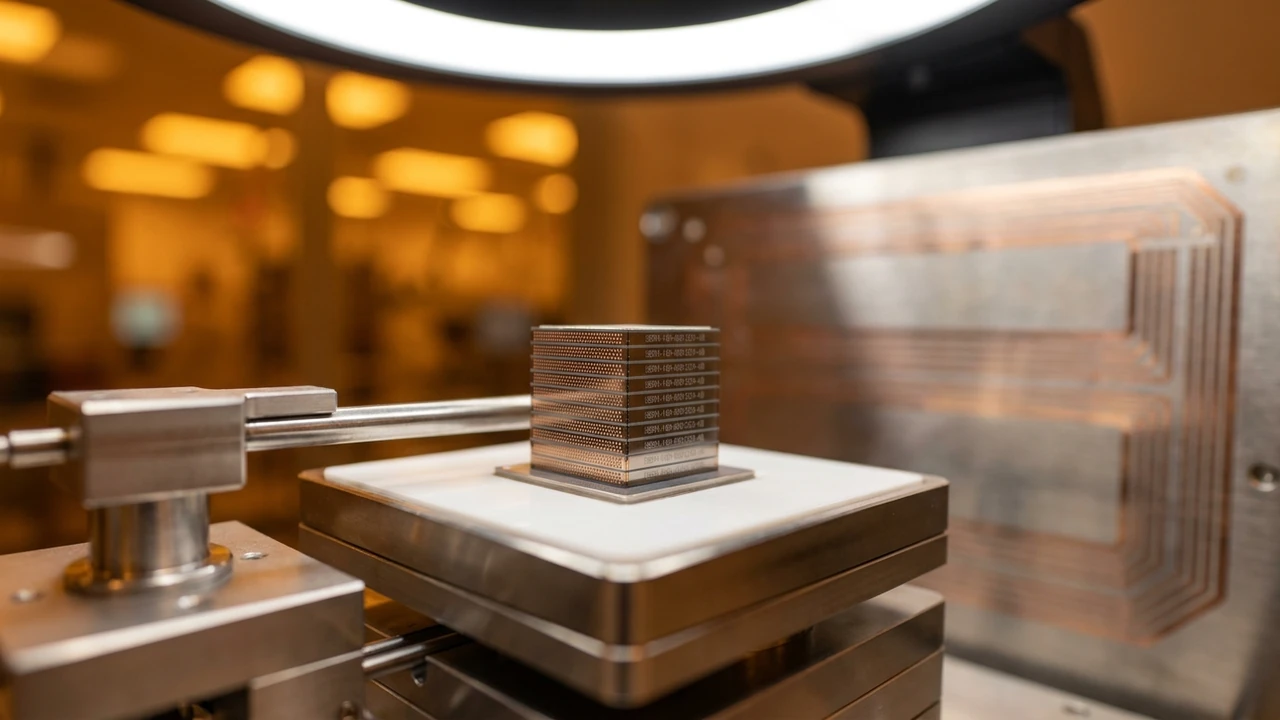
La transición acelerada hacia arquitecturas de aceleradores de inteligencia artificial de próxima generación ha desencadenado una severa escasez estructural de módulos de memoria de alto ancho de banda de cuarta generación (HBM4). Con rendimientos de fabricación iniciales por debajo de las expectativas en las fundiciones de TSMC, combinados con una concentración del 90% de la capacidad fabril en SK Hynix y Samsung Electronics, los tiempos de entrega para clústeres de supercómputo orientados a modelos fundacionales superan ya los 14 meses. Este estrangulamiento en el empaquetado 3D avanzado y el silicio base está forzando a gigantes como Nvidia, AMD y Google Cloud a rediseñar de urgencia sus hojas de ruta de aprovisionamiento, priorizando asignaciones de cómputo y encareciendo los contratos de inferencia y entrenamiento en toda la industria tecnológica global.
1. Génesis y Dimensión Técnica del Cuello de Botella en HBM4
El salto generacional de HBM3e a HBM4 representa el cambio arquitectónico más complejo en la historia del empaquetado avanzado de semiconductores. A diferencia de las iteraciones anteriores, donde la oblea base (base die) se producía con procesos de memoria DRAM estándar, HBM4 introduce la necesidad de fabricar el chip base mediante nodos lógicos avanzados de 3 nanómetros y 4 nanómetros de fundición pura. Esta integración directa de lógica y memoria en una interfaz de 2048 bits —el doble que las generaciones previas— ha llevado la densidad de interconexión a límites térmicos y mecánicos extremos mediante micro-bumps y tecnología de unión híbrida directa (copper-to-copper hybrid bonding).
Los reportes técnicos del sector y análisis de TrendForce confirman que los rendimientos de empaquetado a nivel de oblea sobre sustrato (CoWoS-L) para HBM4 se sitúan actualmente entre el 52% y el 58%. Cada oblea descartada por defectos de alineación o fallos en las vías a través de silicio (TSV) representa una pérdida neta millonaria y semanas de atraso en las líneas de producción de los aceleradores Blackwell Ultra y sus contrapartes en las familias Instinct de AMD y TPUs de sexta generación.
"HBM4 ya no es un componente de memoria convencional que un ensamblador compra en el mercado abierto; es un circuito integrado de lógica avanzada personalizado que comparte oblea y destino térmico con el procesador principal. Quien controle la asignación de slots en las cámaras de deposición física y las líneas de litografía ultravioleta extrema dominará la capacidad computacional efectiva del planeta durante los próximos tres años."
2. Anatomía de la Cadena de Suministro: Oligopolio y Empaquetado Avanzado 3D
La concentración de la oferta mundial de HBM4 expone una fragilidad sistémica sin precedentes en la economía digital. Tres factores dominan la geometría de este suministro restringido:
- Dúopolio Fabril de Alto Rendimiento: SK Hynix retiene más del 54% de las cuotas comprometidas de HBM4 para 2026, respaldada por su liderazgo en encapsulado por compresión térmica con película no conductora (MR-MUF). Samsung Electronics, pese a movilizar inversiones multimillonarias para recapturar cuota, enfrenta curvas de calibración complejas en sus nodos lógicos GAA de 3 nm.
- Saturación de Líneas de CoWoS e Interposers de Silicio: El cuello de botella no radica exclusivamente en el silicio de DRAM, sino en la disponibilidad de sustratos pasivos e interposers gigantescos necesarios para interconectar hasta 8 o 12 pilas de HBM4 alrededor de dos dies computacionales reticulados al límite del tamaño de máscara litográfica.
- Guerra de Asignaciones Prioritarias (Allocation Wars): Los tres grandes hyperscalers (Microsoft, Amazon y Google) han reservado mediante pagos adelantados no reembolsables más del 70% de la producción total estimada para los cuatro trimestres venideros, dejando a empresas emergentes, institutos de investigación y desarrolladores independientes sin acceso directo a hardware de última hornada.
3. Análisis FinOps, CapEx de Infraestructura y Encarecimiento de Tokens
La escasez de HBM4 produce un efecto dominó que impacta de manera inmediata en la economía del cloud computing y las estructuras de costos operativos de los departamentos de IT:
- Inflación en el Costo Unitario de Aceleradores: El precio por módulo de 36 GB y 48 GB de HBM4 ha escalado un 42% interanual, situando el costo de la memoria en más del 38% del costo total de lista de cada acelerador de servidor de IA de alta gama.
- Presión Alcista en Precios de Inferencia de Modelos Extensos: Al encarecerse el CapEx de los servidores, los proveedores cloud están revisando al alza las tarifas por millón de tokens procesados en modelos con ventanas de contexto superiores a 500.000 tokens, donde el ancho de banda de memoria por chip es el determinante directo de la latencia (Time to First Token) y el rendimiento agregado.
- Prolongación del Ciclo de Amortización: Los directores de finanzas (CFOs) de centros de datos están forzados a extender la vida útil proyectada de sus clústeres basados en HBM3 y HBM3e de 3 a 5 años, recurriendo a técnicas de cuantización severa (FP4, INT4) y paralelismo especulativo para exprimir la memoria existente sin incurrir en renovación de hardware.
4. Repercusiones Estratégicas para la Industria Tecnológica en Argentina y América Latina
Para el ecosistema productivo y las empresas de software de Argentina y la región, la crisis de suministro de memoria física impone una redefinición táctica ineludible:
- Restricción en la Disponibilidad de Instancias Cloud Locales: Las zonas cloud regionales de San Pablo, Santiago y los data centers proyectados en Buenos Aires experimentarán demoras en la incorporación de instancias GPU de frontera, concentrándose los nuevos chips en centros de datos primarios de Estados Unidos y Europa.
- Imperativo de Eficiencia Algorítmica y SLMs: Las software houses y PyMEs tecnológicas argentinas no pueden competir alquilando capacidad bruta de cómputo inflacionada. La ventaja competitiva radica en adoptar modelos pequeños y especializados (Small Language Models - SLMs), optimizaciones de destilación y arquitecturas de Mixture of Experts (MoE) que funcionen eficientemente en memoria convencional o hardware accesible.
- Oportunidad en Servicios de Refactorización y FinOps: Crece exponencialmente la demanda de consultores locales con experiencia en frameworks de inferencia como vLLM, TensorRT-LLM y TGI, capaces de reducir el consumo de VRAM de aplicaciones corporativas y recortar facturas cloud de clientes globales en dólares.
5. Respuestas Tecnológicas: Cuantización, Caché Distribuido y Desacople de Memoria
La imposibilidad de resolver la escasez física de silicio a corto plazo está impulsando una ola de innovación en software de bajo nivel y protocolos de interconexión:
Sistemas como CXL 3.1 (Compute Express Link) para pools de memoria compartida desagregada sobre PCIe Gen 6 están siendo implementados para aliviar la presión sobre la memoria en placa, permitiendo que nodos de inferencia accedan a búferes de DRAM DDR5 de alta capacidad con latencias tolerables para tareas de retención de contexto largo (KV Cache Offloading). Asimismo, las técnicas de compresión adaptativa de contexto y atención dispersa (sparse attention) están reduciendo la huella de memoria por consulta hasta en un 65%, mitigando la necesidad de adquirir racks adicionales con HBM4.
6. Hoja de Ruta Operativa: Estrategia de Resiliencia ante la Escasez de Hardware
Checklist estructurado en 4 fases para líderes de infraestructura, CTOs y directores de ingeniería de datos:
- Auditoría Integral de Utilización de VRAM: Monitorear la telemetría de memoria en clústeres y servicios contratados mediante herramientas como NVIDIA DCGM y Prometheus, identificando cuellos de botella por asignación ociosa o fugas en búferes de tensores.
- Adopción Mandatoria de Cuantización y Paginación de Memoria: Estandarizar el despliegue de modelos productivos utilizando formatos optimizados AWQ o FP8 y motores de inferencia basados en PagedAttention para duplicar el rendimiento por gigabyte disponible.
- Diversificación Multicloud y Reservas Prepagas Flexibles: Negociar contratos de capacidad con proveedores alternativos de cómputo especializado (CoreWeave, Lambda Labs, Scaleway) en lugar de depender exclusivamente de un único hiperscaler con cuotas de hardware congeladas.
- Desarrollo de Pruebas de Desempeño sobre Arquitecturas Alternativas: Evaluar cargas de trabajo en aceleradores basados en memoria LPDDR5X masiva o procesadores neuronales dedicados que presenten mayor disponibilidad de stock comercial para tareas analíticas no fundacionales.
Fuentes & Referencias Verificadas
¿Querés maximizar el retorno de inversión en proyectos de transformación digital?
En Siglo 21 Soluciones calculamos el ROI real y la eficiencia de capital para tus implementaciones de software e infraestructura tecnológica.
Contactar a un Consultor