Crisis en la cadena de empaquetado avanzado para memorias HBM4 amenaza el suministro de clústeres de IA
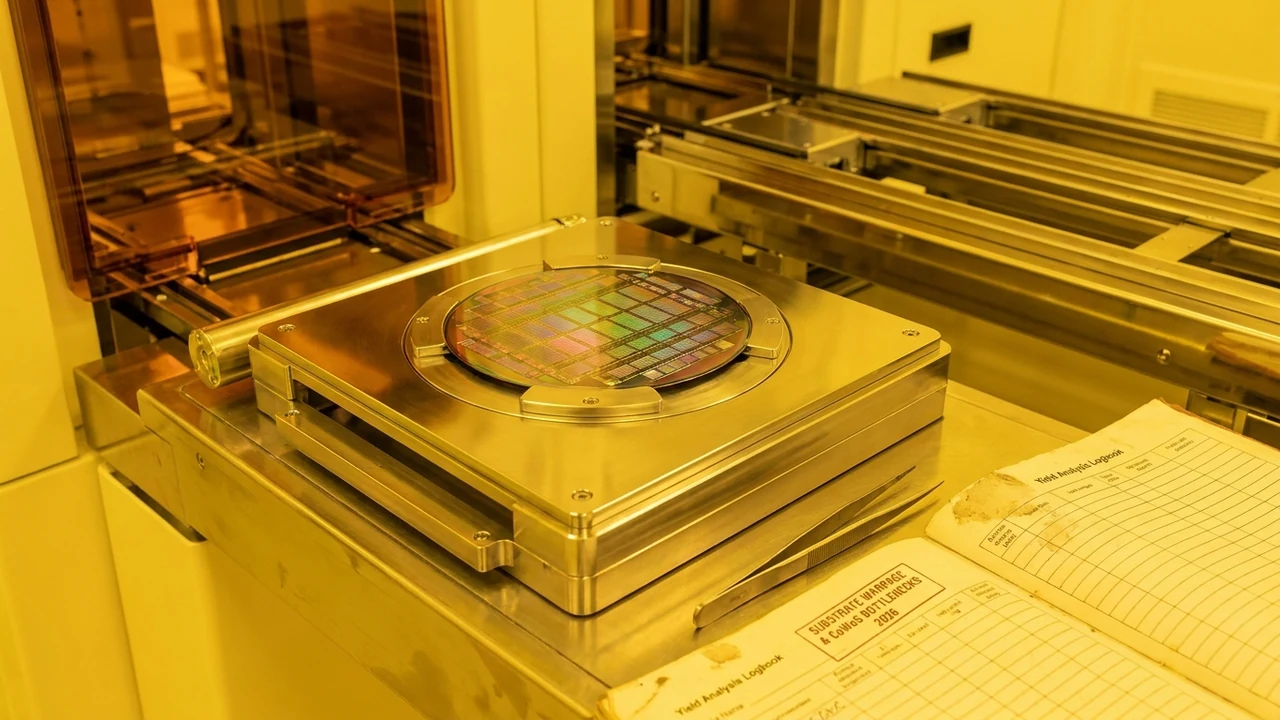
La escalada en la demanda de aceleradores de inteligencia artificial para modelos de frontera ha colisionado de frente con una barrera física insoslayable: la escasez crítica de capacidad de empaquetado avanzado tridimensional para módulos de memoria HBM4 (High Bandwidth Memory 4). Según revelan los últimos reportes de mercado y estimaciones de TrendForce, los rendimientos en sala limpia para el apilamiento de 16 matrices DRAM sobre bases lógicas personalizadas apenas promedian entre el 52% y el 57% en las fundiciones de Taiwán y Corea del Sur. Con plazos de entrega que superan ya los 14 meses para clústeres de cómputo basados en arquitecturas Blackwell Ultra y equivalentes, el mercado de hardware entra en una fase de severo racionamiento que distorsiona las cotizaciones bursátiles de los fabricantes de memorias, infla las tarifas por millón de tokens procesados y obliga a las corporaciones globales y regionales a rediseñar de urgencia sus presupuestos de infraestructura cloud.
1. Génesis del Cuello de Botella: La Ruptura Paradigmática de HBM4
El salto generacional desde HBM3e hacia HBM4 no es una mera actualización incremental de frecuencias de reloj, sino una transformación radical en la arquitectura de silicio. Por primera vez en la industria de la computación distribuida, el chip base (base die) sobre el que descansan las pilas de DRAM ya no se fabrica mediante procesos convencionales de memoria, sino utilizando nodos lógicos avanzados de fundición en geometrías de 3 y 4 nanómetros. Esta convergencia exige una integración litográfica milimétrica entre la fundición de silicio y los ensambladores de memoria (Micron, SK Hynix y Samsung Electronics).
La interfaz de memoria de HBM4 duplica los canales físicos a 2048 bits de ancho de bus, lo que multiplica exponencialmente el número de micro-vías a través de silicio (TSV - Through-Silicon Vias) y requiere tecnologías de unión híbrida directa (hybrid bonding cobre a cobre). En este régimen térmico y estructural, la menor dilatación diferencial durante los ciclos de soldadura por reflujo provoca microfracturas o pérdidas de conductividad en los pines de interconexión, reduciendo drásticamente el rendimiento útil de las obleas complejas y encareciendo la producción a niveles sin precedentes.
"HBM4 ha dejado de ser un commodity de memoria para convertirse en una pieza de artesanía litográfica a escala atómica. Quienes suponen que la capacidad de cómputo en inteligencia artificial puede escalarse indefinidamente ignoran que las cámaras de deposición química y las máquinas de alineación de obleas 3D tienen una capacidad física instalada finita, monopolizada y extraordinariamente sensible a perturbaciones operativas."
2. Geopolítica del Silicio: Oligopolio y la Disputa Micron, SK Hynix y Samsung
La cadena de valor global de HBM4 exhibe una concentración geográfica y corporativa alarmante. Mientras SK Hynix lidera el volumen comprometido gracias a su madurez técnica en encapsulado MR-MUF (Mass Reflow Molded Underfill), Micron Technology acelera su penetración respaldada por subsidios del CHIPS Act estadounidense, buscando consolidar su nodo 1-beta en suelo norteamericano. Samsung, por su parte, apuesta a su integración vertical total para ofrecer soluciones unificadas de fundición y memoria, aunque enfrenta dificultades persistentes de rendimiento en sus nodos GAA.
La gravedad del problema radica en el cuello de botella que representa el interposer de silicio y la tecnología CoWoS (Chip-on-Wafer-on-Substrate). Aunque TSMC ha cuadruplicado sus plantas dedicadas en Taichung y Chiayi, la demanda combinada de Nvidia, AMD, Google (TPU v6) y Amazon (Trainium 3) excede la oferta mundial en más de un 40%. Esta saturación ha desatado una guerra encarnizada de asignaciones (allocation wars), donde los tres grandes hiperscalers han prepagado contratos plurianuales en efectivo, dejando a proveedores de nube de segundo nivel y proyectos soberanos en una situación de virtual desabastecimiento.
3. Análisis FinOps, CapEx de Centros de Datos y Derivadas Financieras
Las implicaciones económicas de este cuello de botella son inmediatas para las organizaciones consumidoras de cómputo intensivo:
- Incremento Vertical del CapEx en Servidores: El módulo de memoria HBM4 representa ahora entre el 35% y el 42% del costo de lista total de un servidor de IA de 8 sockets, disparando el precio por unidad por encima de los USD 380.000 para configuraciones completas de rack denso.
- Volatilidad y Presión Alcista en Tarifas de Inferencia: Al no ingresar nuevos clústeres al ritmo proyectado, los proveedores de nube pública han suspendido los descuentos por volumen en instancias reservadas, encareciendo el procesamiento de modelos con ventanas de contexto gigantes (superiores a 1 millón de tokens) en un 28% acumulado en el último trimestre.
- Extensión Forzada del Ciclo de Vida del Hardware HBM3/3e: Los equipos de FinOps corporativos están recalculando la tasa de depreciación de sus aceleradores actuales, extendiendo los periodos de amortización contable de 3 a 5 años mediante técnicas avanzadas de cuantización (FP4, INT4) y algoritmos de compresión de KV Cache para no tener que renovar flotas de GPUs a precios de escasez.
4. Impacto Estratégico en la Economía Digital de Argentina y América Latina
Para el ecosistema corporativo y los líderes de ingeniería de software en América Latina, este fenómeno impone restricciones prácticas concretas:
- Atraso en Nodos Cloud Locales: Las inversiones para equipar zonas de disponibilidad en San Pablo, Santiago y los proyectos de datacenters en Argentina sufrirán postergaciones de entre 6 y 12 meses, ya que los fabricantes priorizan abastecer los centros de cómputo en América del Norte y Europa occidental.
- El Imperativo de la Eficiencia Algorítmica (Small Language Models): Las empresas y desarrolladores argentinos no pueden permitirse el lujo de depender de instancias sobredimensionadas. La necesidad acelera la adopción de modelos compactos y especializados (SLMs) y frameworks de inferencia de alto rendimiento como vLLM o TensorRT, que maximizan el rendimiento por gigabyte de VRAM disponible.
- Oportunidad en Servicios Profesionales de Optimización: La escasez abre un mercado de exportación de servicios de alto valor para ingenieros de sistemas argentinos especializados en cuantización, poda de redes y reingeniería de pipelines de machine learning para clientes de Estados Unidos que buscan recortar facturas cloud multimillonarias.
5. Respuestas Tecnológicas: CXL 3.1, Desacople de Memoria y Paginación Tensor
Ante la imposibilidad de multiplicar las fábricas de obleas de la noche a la mañana, la industria responde mediante innovaciones a nivel de sistema operativo y arquitectura de memoria desacoplada:
El estándar Compute Express Link (CXL 3.1) está permitiendo agrupar memorias DDR5 convencionales en pools compartidos de bajísima latencia a través de buses PCIe Gen 6. Aunque el ancho de banda no alcanza los 3 TB/s de una pila HBM4, la memoria desagregada resulta idónea para almacenar los estados de contexto históricos de agentes autónomos, liberando la preciada memoria HBM integrada para las matrices de multiplicación densa. En paralelo, el auge de técnicas como PagedAttention y la atención dispersa (sparse attention) permite mitigar hasta en un 50% los requerimientos de memoria física durante picos de inferencia concurrente.
6. Hoja de Ruta Operativa: Resiliencia de Infraestructura ante la Escasez de Silicio
Checklist estructurado en cuatro fases para CIOs, directores de infraestructura y líderes de datos:
- Auditoría Exhaustiva de Utilización de Memoria en Clústeres: Implementar métricas de telemetría por GPU mediante NVIDIA DCGM o Prometheus para detectar asignaciones estáticas redundantes y fuga de búferes en modelos de producción.
- Migración Mandatoria a Formatos Cuantizados: Convertir todas las cargas de trabajo de inferencia desde FP16 a representaciones calibradas AWQ, GPTQ o FP8, reduciendo a la mitad los requerimientos de memoria sin degradación medible en la precisión de respuesta.
- Contratación Multicloud y Agregadores de Cómputo Alternativo: Evitar la exclusividad con un único proveedor dominante y diversificar hacia infraestructuras descentralizadas o especializadas (CoreWeave, Lambda Labs) con acuerdos de nivel de servicio garantizados.
- Evaluación de Procesadores Perimetrales y NPU Dedicadas: Probar cargas de trabajo de análisis y clasificación en silicio de arquitectura híbrida LPDDR5X, descongestionando las colas de procesamiento de los clústeres principales de entrenamiento.
Fuentes & Referencias Verificadas
¿Querés maximizar el retorno de inversión en proyectos de transformación digital?
En Siglo 21 Soluciones calculamos el ROI real y la eficiencia de capital para tus implementaciones de software e infraestructura tecnológica.
Contactar a un Consultor