Tribunales en Estados Unidos admiten demanda colectiva contra el rastreo masivo de código para entrenamiento de IA
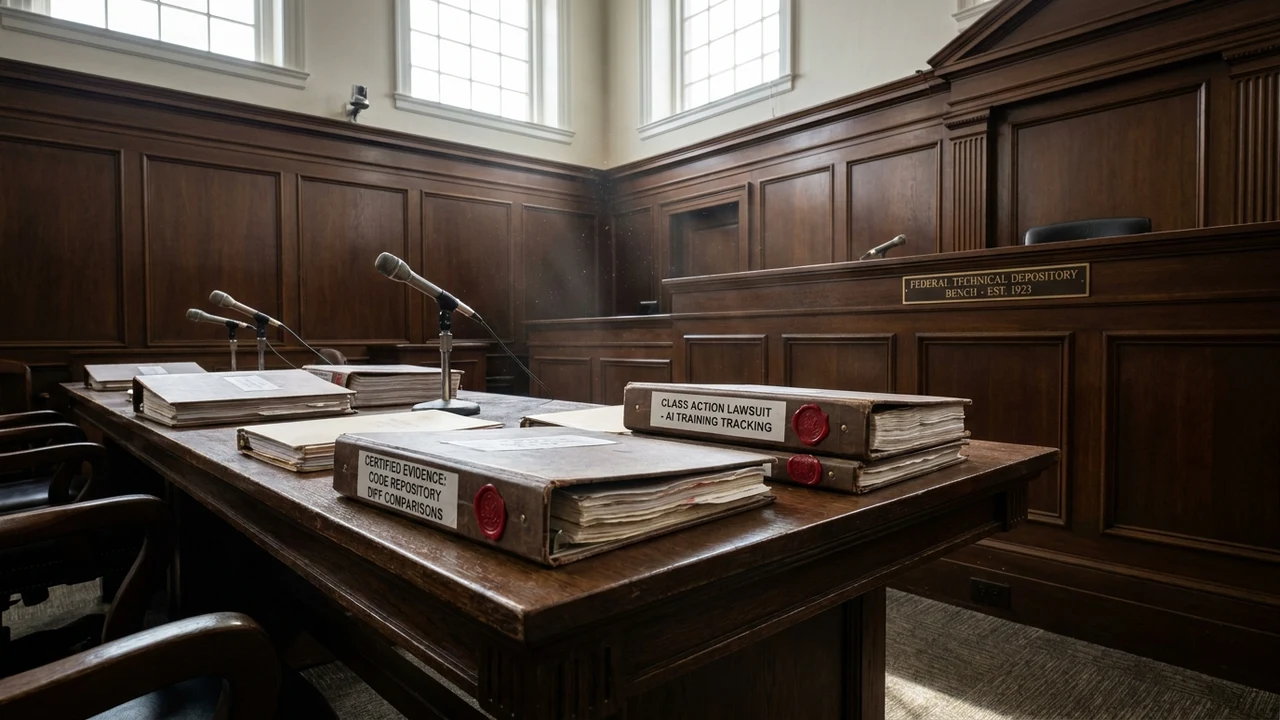
En un fallo judicial que promete reconfigurar las bases jurídicas del entrenamiento de modelos de lenguaje para programación, un tribunal federal de apelaciones de los Estados Unidos ha determinado la admisión formal a trámite de una histórica demanda colectiva (class action) promovida por desarrolladores de software independiente contra los principales proveedores de asistentes de codificación con inteligencia artificial. Reportado por Ars Technica y analizado desde la perspectiva de derechos civiles digitales por la Electronic Frontier Foundation (EFF), el tribunal dictaminó que la ingesta masiva de repositorios de código abierto sin preservar los avisos de autoría, licencias de atribución (MIT, Apache 2.0, GPL) y restricciones de redistribución amerita un juicio de fondo sobre infracción a la Ley de Derechos de Autor del Milenio Digital (DMCA) y competencia desleal.
1. Anatomía y Contexto: El Choque entre la Cultura Open Source y la Monetización Privada
Durante más de tres décadas, el ecosistema de código abierto floreció bajo un pacto social tácito: programadores de todo el mundo compartían gratuitamente su trabajo bajo licencias libres que exigían una contraprestación fundamental: la atribución del autor original y, en el caso de licencias copyleft como la GPL, el compromiso de mantener abiertos los trabajos derivados. Este modelo colaborativo construyó los cimientos de la infraestructura digital moderna, desde el núcleo de Linux hasta los servidores web y compiladores que sostienen Internet.
La irrupción de modelos de lenguaje entrenados para escribir software rompió este equilibrio. Las empresas de tecnología rastrearon miles de millones de líneas de código desde repositorios públicos como GitHub, GitLab y Stack Overflow, utilizando ese conocimiento colectivo para entrenar redes neuronales que hoy se comercializan mediante suscripciones de pago mensuales. Cuando estos asistentes generan fragmentos de código idénticos a los del repositorio original pero omiten el nombre del programador o los términos de la licencia, los desarrolladores argumentan que se está despojando a la comunidad de sus derechos legítimos mediante una usurpación corporativa sin precedentes.
El fallo judicial desestima las mociones de desestimación previa presentadas por los demandados, quienes sostenían que el entrenamiento constituía un uso legítimo ("fair use") transformativo protegido por la ley estadounidense. Al admitir que la eliminación intencional de la información de gestión de derechos de autor (CMI bajo la Sección 1202(b) de la DMCA) es un reclamo legalmente viable, el tribunal abre las puertas a una fase de descubrimiento de pruebas que obligará a las empresas a revelar qué datos exactos utilizaron y cómo funcionaron sus filtros de extracción.
"El código abierto no es código sin derechos ni un recurso natural gratuito para la extracción corporativa sin límites. Las licencias como GPL y MIT son contratos vinculantes que exigen atribución y respeto a la comunidad. Si una corporación comercializa un producto derivado del esfuerzo de millones de voluntarios mientras elimina deliberadamente sus firmas y licencias, está violando la ley federal y erosionando las bases del movimiento de software libre."
2. Complejidades Técnicas: Memorización de Código, Filtros de Coincidencia y Parámetros Latentes
El debate judicial trasciende las cuestiones puramente dogmáticas del derecho para adentrarse en la mecánica probabilística de cómo los modelos procesan y regurgitan código:
- El Fenómeno de la Regurgitación de Código Idéntico: Investigaciones académicas han demostrado que los modelos de lenguaje para código tienden a memorizar y reproducir bloques de texto de manera literal, especialmente en funciones con firmas algorítmicas distintivas o soluciones a problemas matemáticos complejos. Cuando la temperatura de muestreo es baja, el modelo puede emitir decenas de líneas de código verbatim sin ninguna alteración sintáctica.
- Insuficiencia de los Filtros de Coincidencia de Código (Code Matching Filters): Aunque las plataformas comerciales implementaron filtros heurísticos diseñados para bloquear respuestas que coincidan en más de 150 caracteres con el conjunto de entrenamiento público, los demandantes demostraron que el modelo puede eludir fácilmente estos filtros mediante cambios triviales de nombres de variables o reformateo de espacios, manteniendo la estructura lógica propietaria intacta.
- Dificultad de Desaprendizaje Algorítmico (Machine Unlearning): Si los tribunales dictaminan que ciertos repositorios fueron ingeridos de manera ilícita, obligar a las empresas a "olvidar" esos datos representa un reto técnico monumental. La eliminación de pesos específicos en un modelo pre-entrenado suele degradar de forma impredecible las capacidades del sistema completo, forzando en muchos casos a reentrenar la arquitectura desde cero a un costo de decenas de millones de dólares.
3. Análisis Financiero y FinOps: Riesgo de Indemnizaciones Masivas y Modelos de Licenciamiento
Las implicancias económicas del avance de esta demanda colectiva amenazan con transformar radicalmente la estructura financiera de los proveedores de IA para desarrollo:
- Riesgo de Daños Estatutarios Multimillonarios: La Sección 1202 de la DMCA contempla daños estatutarios que oscilan entre USD 2.500 y USD 25.000 por cada infracción probada. Considerando que las plataformas han generado miles de millones de sugerencias de código a lo largo de los últimos tres años, una sentencia adversa en un juicio por jurados podría acarrear pasivos de dimensiones existenciales para las compañías demandadas.
- Transición hacia Conjuntos de Datos Éticos y Licenciados (CapEx de Adquisición): Para blindarse legalmente, las empresas de software ya están comenzando a negociar acuerdos de licenciamiento remunerado con desarrolladores y consorcios abiertos, un gasto de capital emergente que encarecerá el costo de desarrollo de modelos especializados en un 20% a 30%.
- Repercusiones en Empresas Clientes (Riesgo de Indemnización de Propiedad Intelectual): Las organizaciones que utilizan estos asistentes para programar sus propias aplicaciones temen que el código generado contenga licencias restrictivas (como GPL viral) que contaminen sus productos comerciales, obligándolas a liberar su propio código fuente o enfrentar litigios por infracción de patentes.
4. Implicancias y Oportunidades para Empresas y PyMEs de Argentina y América Latina
Para la pujante industria del software y los desarrolladores de América Latina, este litigio sienta precedentes de enorme relevancia práctica:
- Protección de la Propiedad Intelectual de Desarrolladores Regionales: Históricamente, miles de programadores argentinos y latinoamericanos han contribuido con librerías abiertas a repositorios globales sin recibir retribución económica. Este fallo valida que su trabajo no puede ser explotado comercialmente por corporaciones extranjeras sin respetar al menos el reconocimiento moral y la atribución de autoría.
- Necesidad de Políticas Corporativas de Gobierno de Código Generado: Las empresas de desarrollo de software en Argentina que exportan servicios a Estados Unidos y Europa deben implementar auditorías rigurosas de composición de software (SCA) para asegurar que el código sugerido por asistentes no introduzca fragmentos protegidos por licencias copyleft en proyectos propietarios de sus clientes extranjeros.
- Oportunidad para Herramientas de Auditoría y Verificación de Licencias: Startups locales de tecnología pueden desarrollar herramientas de escaneo y trazabilidad en tiempo real que comparen el código producido por los equipos de desarrollo contra bases de datos de código abierto, certificando a los clientes que el software entregado está 100% libre de contaminación por licencias restringidas.
5. Hoja de Ruta Técnica: Checklist de Implementación en 4 Pasos
Los gerentes de ingeniería y líderes de desarrollo deben establecer salvaguardas inmediatas en sus flujos de trabajo de programación asistida por IA:
- Activar Filtros Estrictos de Detección de Código Público: Configurar en los paneles de administración de GitHub Copilot, Cursor u otros asistentes corporativos la opción de "bloquear sugerencias que coincidan con código público conocido" (block suggestions matching public code).
- Integrar Escáneres de Composición de Software (SCA) en los Pipelines de CI/CD: Desplegar herramientas automáticas (como FOSSA, Snyk Open Source o Black Duck) en los flujos de integración continua para auditar cada pull request en busca de fragmentos de código con licencias incompatibles antes del despliegue a producción.
- Actualizar las Políticas de Propiedad Intelectual y Uso Aceptable de IA: Redactar y socializar directrices claras para los desarrolladores de la empresa sobre cómo y cuándo está permitido utilizar asistentes de IA, prohibiendo su uso en componentes centrales de algoritmos patentables.
- Exigir Garantías de Indemnización Legal a los Proveedores de Asistentes: Revisar los acuerdos comerciales con los proveedores de herramientas de IA, verificando que incluyan cláusulas de indemnización y defensa legal en caso de demandas por infracción de propiedad intelectual derivadas de sugerencias del modelo.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor