SpaceXAI publica 'Grok Voice Transcribe 2.0' con redes neuronales de aislamiento de audio en entornos aeronáuticos e industriales
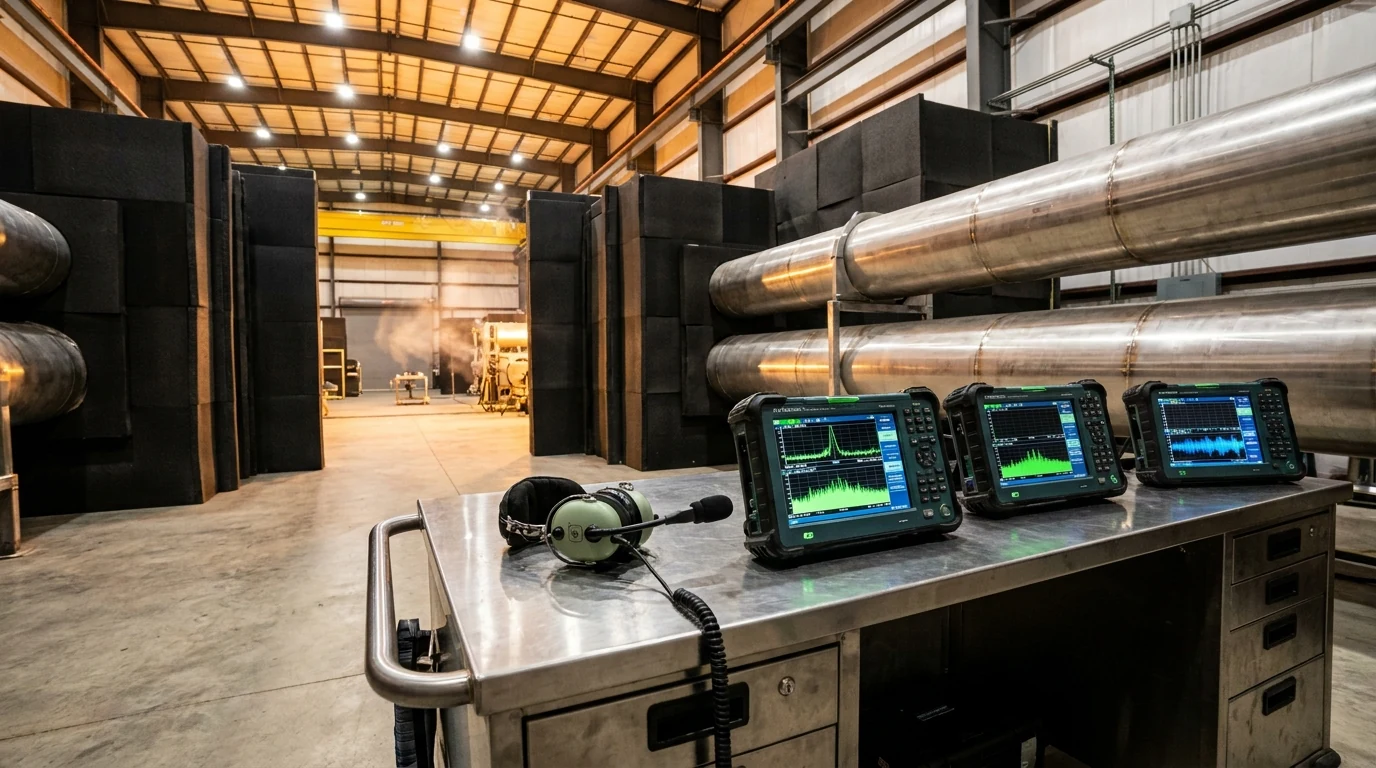
SpaceXAI liberó la versión 2.0 de su motor de reconocimiento acústico Grok Voice Transcribe, incorporando redes neuronales convolucionales profundas de separación de fuentes sonoras capaces de aislar comandos de voz humana en cabinas de naves espaciales, pistas de aterrizaje y talleres mecánicos con más de 95 decibelios de interferencia acústica continua.
El reconocimiento del habla en condiciones operativas extremas ha superado su barrera física más compleja. SpaceXAI, la división de ingeniería de inteligencia artificial vinculada a los programas aeroespaciales de Starbase y Starlink, publicó hoy, domingo 20 de septiembre de 2026, la actualización mayor de su modelo 'Grok Voice Transcribe 2.0'. Diseñado originalmente para procesar las transmisiones de telemetría de voz de los astronautas durante las fases críticas de ignición de propulsores de cohetes, el software fue adaptado como una API comercial abierta para industrias pesadas donde el ruido ensordecedor suele dejar inoperables a los asistentes de voz comunes.
A diferencia de los modelos acústicos convencionales que aplican compuertas de ruido lineales o supresión espectral estática —mecanismos que suelen recortar consonantes y distorsionar palabras clave de mando—, Grok Voice Transcribe 2.0 implementa una arquitectura neuronal de 'Máscaras Espectro-Temporales Profundas'. La red fue entrenada con más de 200.000 horas de grabaciones en hangares industriales, túneles de viento supersónicos y plataformas de perforación marítima, lo que le permite reconstruir los formantes vocales y transcribir con una tasa de error de palabras (WER) inferior al 1,8% en ambientes de hasta 100 dB.
1. Arquitectura de Separación Espectral y Modelado Fonético Resiliente
La innovación arquitectónica de la versión 2.0 descansa en el desacoplamiento en dos fases del procesamiento acústico: la red 'AeroFilter', que proyecta el espectrograma ruidoso en un espacio latente de alta dimensión para suprimir armónicos mecánicos de turbinas y motores diésel, y el codificador 'GrokAcoustic', que transcribe el flujo fonético purificado en tiempo real con una latencia de apenas 180 milisegundos.
Además de su precisión fonética, el modelo incluye un clasificador de estrés fisiológico que analiza la micro-tensión de las cuerdas vocales del emisor. En contextos de emergencia aeronáutica o industrial, el sistema alerta de manera proactiva al centro de control si detecta patrones vocales compatibles con hipoxia, dolor agudo o fatiga extrema en los pilotos y operadores de maquinaria, transformando la transcripción en un sensor biomédico de alerta temprana.
«En el espacio o en una planta química un solo comando mal interpretado por interferencia de ruido puede significar la pérdida de una misión o una catástrofe humana; Grok Voice 2.0 garantiza que la voz humana se escuche con absoluta nitidez sin importar el caos acústico del entorno» — Dr. Christian Szegedy, científico principal de modelos acústicos en xAI, en la memoria técnica difundida en xAI Engineering
2. Especificaciones Técnicas, API Abierta y Despliegue en Borde
La tecnología de transcripción aeroespacial ofrece prestaciones de nivel militar para aplicaciones civiles y corporativas:
- Inferencia en Dispositivos Rugged y Borde: El modelo puede empaquetarse en microcontroladores y chips DSP de bajo consumo para cascos de seguridad y radios tácticas.
- Soporte Multilingüe para Jergas Técnicas: Comprensión exacta de siglas de aviación (código OACI), nomenclatura naval y comandos de ingeniería de yacimientos.
- Latencia de Procesamiento de 180 ms: Capacidad de procesar audio en tiempo real sin requerir pausas ni almacenamiento previo en buffers locales prolongados.
- Aislamiento de Múltiples Hablantes Superpuestos: Identificación biométrica y separación de conversaciones simultáneas en cabinas de pilotaje abarrotadas.
Este despliegue sitúa a la API de Grok Voice como el nuevo estándar de oro para sistemas de misión crítica en transporte e industria.
3. Análisis FinOps, Prevención de Siniestros y Aplicaciones en Minería y Agro
La incorporación de transcripción resiliente genera beneficios directos en seguridad operativa y control de costos:
- Reducción de Incidentes Operativos en Plantas: La captura precisa de órdenes verbales previene fallas humanas que cuestan anualmente millones en paradas de planta.
- Ahorro en Hardware Especializado: Elimina la necesidad de instalar costosos micrófonos de garganta o laringófonos en cuadrillas de mantenimiento industrial.
- Eficiencia en Yacimientos Mineros y Petroleros de LatAm: Operarios en Vaca Muerta o el Altiplano pueden asentar partes de inspección por voz sin bajarse de la maquinaria pesada.
- Integración Directa con Sistemas ERP y Mantenimiento: Carga automática de bitácoras de trabajo en SAP o Salesforce mediante comandos de voz estructurados en cabina.
Para gerentes de operaciones y CFOs industriales, digitalizar los partes verbales en ambientes ruidosos maximiza la rentabilidad y la trazabilidad de los activos.
4. Hoja de Ruta y Checklist de Implementación Técnica en 5 Fases
- Fase 1: Mapeo Acústico de Puntos Críticos de Trabajo: Medir los niveles de presión sonora (dB) en hangares, salas de máquinas y líneas de producción.
- Fase 2: Instalación de la API de Grok Voice en Dispositivos Móviles: Integrar el SDK en las terminales de radio digital o teléfonos rugerizados de los operarios.
- Fase 3: Calibración de Vocabularios Industriales Específicos: Ajustar los pesos fonéticos del modelo a los términos técnicos y modismos propios de la empresa.
- Fase 4: Enlace con Sistemas de Órdenes de Mantenimiento: Automatizar la conversión de audio a tickets de trabajo en las plataformas de gestión de planta.
- Fase 5: Capacitación en Protocolos de Comunicación Segura: Instruir a los trabajadores en la emisión de comandos estructurados para maximizar la velocidad de respuesta del sistema.
¿Buscás implementar reconocimiento de voz e interfaces en entornos de alta exigencia?
En Siglo 21 Soluciones integramos modelos de procesamiento acústico avanzado y arquitecturas de misión crítica.
Fuentes & Referencias Verificadas
¿Buscás implementar reconocimiento de voz e interfaces en entornos de alta exigencia?
En Siglo 21 Soluciones integramos modelos de procesamiento acústico avanzado y arquitecturas de misión crítica.
Contactar a un Consultor