Shanghai AI Laboratory publica el modelo abierto Atria-Dawn-Preview bajo licencia permisiva MIT
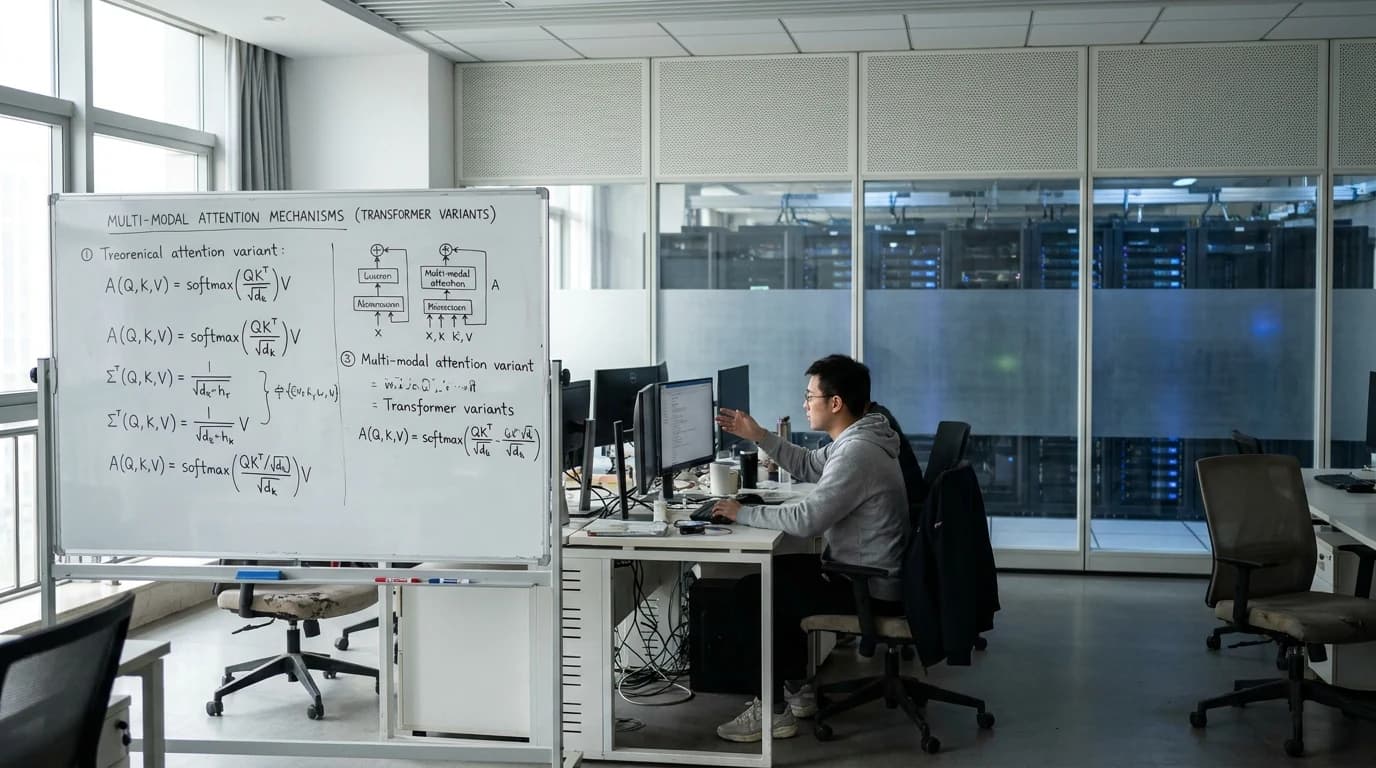
El reconocido Shanghai AI Laboratory sorprendió a la comunidad de código abierto al publicar los pesos completos y la arquitectura técnica de 'Atria-Dawn-Preview', un modelo fundacional multimodal de última generación distribuido bajo licencia permisiva MIT que permite uso, modificación y explotación comercial sin regalías.
El ecosistema global de código abierto y computación científica ha recibido un nuevo catalizador de primer orden. El prestigioso Shanghai Artificial Intelligence Laboratory oficializó hoy, viernes 18 de septiembre de 2026, la liberación pública de los pesos neuronales, scripts de entrenamiento y arquitectura técnica de 'Atria-Dawn-Preview'. La gran sorpresa para la industria radica en la elección de su marco de licenciamiento: el modelo fue publicado bajo la licencia de software libre MIT, eliminando barreras de pago, restricciones de soberanía geográfica o regalías comerciales para corporaciones y desarrolladores internacionales.
Atria-Dawn-Preview destaca por su arquitectura híbrida de mezcla dispersa de expertos (MoE) y atención multimodal nativa profunda, capaz de procesar simultáneamente texto de contexto ultra-largo (hasta 1 millón de tokens), visión de alta resolución espacial, diagramas de ingeniería y secuencias de código binario. Con una eficiencia de inferencia diseñada para ejecutarse en clusters de GPUs estándar mediante técnicas de cuantización FP8 e INT4, la propuesta china desafía de manera directa el monopolio de las APIs cerradas de las multinacionales estadounidenses.
1. Arquitectura MoE Dispersa y Fusión Multimodal sin Pérdida
A diferencia de los modelos multimodales convencionales que adaptan codificadores visuales externos mediante capas de proyección lineal tardías, Atria-Dawn integra tokens de imagen, audio y texto en una representación latente unificada desde las primeras etapas del pre-entrenamiento. Esto le permite comprender relaciones espaciales milimétricas en planos arquitectónicos, inspeccionar placas de circuitos electrónicos y razonar sobre secuencias de video en tiempo real sin degradar su rendimiento en tareas de lógica verbal pura.
La arquitectura activa únicamente 18.000 millones de parámetros por cada token procesado sobre un total de 142.000 millones de parámetros del modelo global. Este desacoplamiento selectivo de expertos garantiza un rendimiento en benchmarks de matemáticas y programación comparable a GPT-5 y Claude 4, pero reduciendo el consumo energético de inferencia en más de un 60%, facilitando su auto-hospedaje en infraestructuras locales y centros de datos regionales.
«La verdadera democratización de la inteligencia artificial exige que los modelos de mayor capacidad pertenezcan al dominio público; con Atria-Dawn bajo licencia MIT, entregamos a universidades, startups e industrias una herramienta soberana para innovar sin dependencias monopólicas» — Dra. Ling Zhang, investigadora jefa en Shanghai AI Lab, según recogió el reporte especial de Emergent
2. Ventajas del Modelo Libre y Autonomía de Infraestructura
La disponibilidad de Atria-Dawn bajo términos MIT habilita múltiples casos de uso industrial que antes eran inviables por costos de API o secreto corporativo:
- Despliegue On-Premises Soberano: Las organizaciones con políticas de privacidad estrictas pueden hospedar el modelo en sus propios servidores sin emitir llamadas a nubes externas.
- Ajuste Fino Completo (Full Fine-Tuning): Acceso irrestricto a los gradientes y capas de pesos para especializar el modelo en jergas médicas, legales o industriales locales.
- Inexistencia de Costos de Licencia por Token: Las empresas eliminan las facturas mensuales variables de inferencia, amortizando únicamente el costo de sus servidores propios.
- Independencia ante Bloqueos Geopolíticos: Garantía de continuidad operativa frente a posibles restricciones de exportación o desconexiones de APIs comerciales extranjeras.
Este lanzamiento afianza la tendencia hacia la descentralización del cómputo inteligente y la consolidación del software abierto como pilar de la soberanía tecnológica.
3. FinOps: Comparativa entre Inferencia Cloud vs. Hosting Local de Atria-Dawn
El análisis financiero para compañías con alto volumen de procesamiento transaccional arroja números contundentes:
- Punto de Equilibrio de Costos (Break-Even): A partir de 150 millones de tokens mensuales, hospedar Atria-Dawn en servidores propios resulta más económico que contratar APIs propietarias.
- Ahorro del 70% en Operaciones de Visión por Computadora: La inferencia visual masiva en control de calidad industrial reduce drásticamente su costo unitario.
- Control Predecible de CapEx: La inversión en equipamiento se amortiza a 36 meses, protegiendo las finanzas de fluctuaciones cambiarias en suscripciones en dólares.
- Optimización con VLLM y Ollama Corporativo: Compatibilidad inmediata con motores de inferencia optimizados que maximizan el throughput de tokens por segundo por vCPU.
Para startups y centros de desarrollo en América Latina, Atria-Dawn representa una oportunidad histórica para construir soluciones competitivas sin asfixia de costos cloud.
4. Hoja de Ruta y Checklist de Implementación Técnica en 5 Fases
- Fase 1: Descarga y Verificación de Checksums del Modelo: Clonar los pesos y especificaciones desde repositorios oficiales verificando firmas SHA-256.
- Fase 2: Aprovisionamiento de Nodos de Cómputo: Configurar servidores locales con soporte para cuantización vLLM y balanceo de memoria GPU/NVMe.
- Fase 3: Implementación de API Interna Compatible con OpenAI: Exponer endpoints locales estándar que permitan conectar aplicaciones existentes sin alterar su código.
- Fase 4: Pruebas de Carga y Evaluación de Latencia: Medir el tiempo hasta el primer token (TTFT) y ajustar la asignación de memoria para picos de concurrencia.
- Fase 5: Fine-Tuning con Datos Propietarios de la Empresa: Entrenar adaptadores LoRA especializados para potenciar la precisión en los procesos neurálgicos del negocio.
¿Te interesa integrar modelos avanzados y agentes de IA en tus flujos de trabajo?
En Siglo 21 Soluciones desarrollamos agentes autónomos, optimizaciones de inferencia y arquitecturas de IA aplicada adaptadas a tus objetivos comerciales.
Fuentes & Referencias Verificadas
¿Te interesa integrar modelos avanzados y agentes de IA en tus flujos de trabajo?
En Siglo 21 Soluciones desarrollamos agentes autónomos, optimizaciones de inferencia y arquitecturas de IA aplicada adaptadas a tus objetivos comerciales.
Contactar a un Consultor