SAIACONF 2026 presentará en Puerto Madero debates sobre modelos abiertos y soberanía de silicio
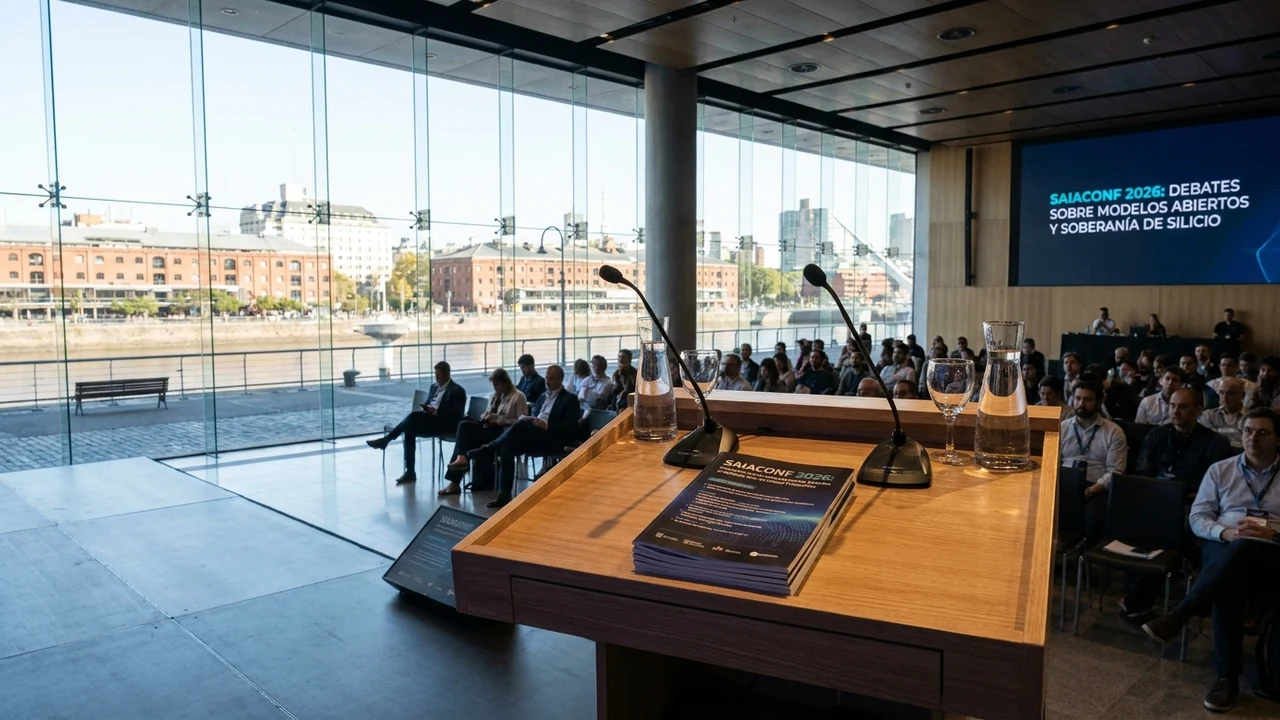
La comunidad científica, tecnológica y empresarial del Cono Sur se prepara para uno de los hitos de divulgación y debate técnico más relevantes del año. De acuerdo con el programa oficial publicado por la Sociedad Argentina de Inteligencia Artificial (SAIA) y las líneas de articulación estratégica promovidas junto a organismos de Ciencia y Tecnología, la cuarta edición de SAIACONF 2026 tendrá lugar en el Centro de Convenciones de Puerto Madero. El encuentro congregará a más de 2.500 profesionales, investigadores, directores de tecnología y autoridades gubernamentales bajo un lema central: la consolidación de modelos fundacionales de código abierto (Open Weights), la creación de clústeres de inferencia local y la soberanía de cómputo en silicio para amortiguar la dependencia geopolítica de las grandes corporaciones extranjeras.
1. Anatomía y Contexto: La Discusión por la Autonomía Tecnológica en el Cono Sur
El vertiginoso avance de la inteligencia artificial a escala global ha planteado un dilema existencial para las economías emergentes de América Latina. Por un lado, la adopción masiva de modelos propietarios provistos por gigantes como OpenAI, Microsoft, Google y Anthropic ha permitido a empresas y administraciones públicas incorporar funcionalidades generativas a gran velocidad. Sin embargo, este paradigma ha profundizado una asimetría estructural: la transferencia masiva de datos corporativos y ciudadanos hacia servidores en el exterior, la sujeción a esquemas de precios dolarizados impredecibles y el riesgo latente de censura, discontinuidad o restricciones comerciales fuera del control regional.
Ante esta coyuntura, la Sociedad Argentina de Inteligencia Artificial ha estructurado la agenda de SAIACONF 2026 como un catalizador para la soberanía tecnológica. El debate ya no se limita a cómo consumir APIs comerciales cerradas, sino a cómo construir capacidades endógenas: cómo entrenar, afinar (fine-tuning) y ejecutar modelos de pesos abiertos (como las familias Llama, Mistral, DeepSeek y Qwen) en centros de datos ubicados en territorio nacional o en hardware de borde (Edge AI) bajo control directo de las organizaciones.
El congreso pondrá un énfasis especial en el llamado "cuello de botella de silicio". En un mundo donde los aceleradores de cómputo de alta gama (GPUs Nvidia H100 y B200) sufren listas de espera prolongadas y barreras arancelarias de importación en Argentina, los ingenieros locales han comenzado a explorar arquitecturas alternativas: procesadores neuronales (NPUs) integrados, arquitecturas basadas en el estándar libre RISC-V, clústeres distribuidos sobre silicio de consumo masivo y técnicas avanzadas de compresión cuántica y modelos de lenguaje pequeños (SLMs) optimizados para hardware modesto.
"América Latina no puede conformarse con el rol pasivo de consumidora de algoritmos empaquetados en California o Pekín. La verdadera soberanía del siglo XXI se juega en la capacidad de auditar los pesos matemáticos de los modelos que toman decisiones sobre nuestros ciudadanos, en entrenar representaciones culturales y lingüísticas propias, y en operar clústeres de cómputo locales que sigan funcionando incluso si se corta la conectividad internacional o se imponen sanciones externas."
2. Arquitectura Técnica Profunda: Modelos Abiertos, Inferencia Cuantizada y RISC-V
Las mesas técnicas y workshops de SAIACONF 2026 profundizarán en las soluciones de ingeniería que permiten democratizar el cómputo de frontera en infraestructuras con limitaciones de recursos:
- Optimización de Inferencia con Motores vLLM y TensorRT-LLM: Demostraciones prácticas de cómo maximizar el rendimiento de tokens por segundo mediante la técnica de PagedAttention, reduciendo la fragmentación de la memoria VRAM en servidores de inferencia compartidos por múltiples aplicaciones.
- Cuantización Extrema (AWQ, GPTQ y GGUF de 2 a 4 bits): Implementaciones avanzadas que permiten ejecutar modelos de 70 mil millones de parámetros (70B) en estaciones de trabajo convencionales con GPUs individuales o clústeres de servidores heterogéneos, sin degradar el razonamiento lógico ni la fluidez sintáctica del lenguaje español rioplatense.
- Arquitecturas de Hardware Abierto con RISC-V y Aceleradores Tensoriales: Presentación de avances de laboratorios de microelectrónica universitarios locales que diseñan aceleradores de hardware dedicados a operaciones matriciales basados en el conjunto de instrucciones libre RISC-V, buscando mitigar el monopolio de las patentes de microprocesadores comerciales.
- Pipelines Soberanos de Retrieval-Augmented Generation (RAG): Arquitecturas de búsqueda y recuperación semántica completamente desconectadas de Internet (air-gapped), implementadas con bases de datos vectoriales locales y modelos de embeddings en español alojados en infraestructura on-premise bajo estrictos estándares de secreto bancario y confidencialidad médica.
3. Análisis Financiero y FinOps: El Caso de Negocio de Modelos Propietarios vs. Open Source
Uno de los paneles más esperados de la conferencia abordará el análisis cuantitativo de costos entre modelos propietarios basados en tokens y despliegues soberanos de código abierto:
- Escalabilidad de Costos Operativos (Tokenomics vs. Cómputo Propio): Una organización que procesa 50 millones de tokens diarios utilizando APIs comerciales de frontera gasta en promedio entre USD 15.000 y USD 35.000 mensuales en facturación de API. En contraste, desplegar un clúster local de inferencia con modelos abiertos cuantizados sobre hardware propio amortizado (CapEx inicial de USD 45.000) reduce el costo operativo recurrente a menos de USD 1.800 mensuales en electricidad y mantenimiento, alcanzando el punto de equilibrio financiero en menos de 4 meses.
- Inmunidad ante la Volatilidad Cambiaria e Impuestos al Dólar: En economías con cepos cambiarios y recargos impositivos sobre pagos en moneda extranjera, la facturación variable de nubes internacionales genera incertidumbre presupuestaria crítica. La infraestructura on-premise o colocada en datacenters locales pesifica los costos y protege el flujo de caja corporativo.
- Retorno de Inversión en Propiedad Intelectual: Los pesos de modelos afinados (LoRA / fine-tuned adapters) con datos confidenciales de la propia empresa quedan registrados como activos intangibles de la sociedad, incrementando la valuación corporativa de cara a rondas de inversión o procesos de due diligence.
4. Implicancias y Oportunidades para Empresas y PyMEs de Argentina
Para las pequeñas y medianas empresas de Argentina, los temas debatidos en SAIACONF 2026 representan una guía práctica para escapar de la trampa del subdesarrollo digital. En lugar de pagar licencias prohibitivas en moneda dura por herramientas que a menudo no comprenden las complejidades regulatorias, fiscales o coloquiales de la región, las PyMEs pueden apoyarse en la comunidad de código abierto para desplegar soluciones personalizadas de alta fidelidad.
El congreso funcionará además como un nodo de vinculación laboral y comercial directo, conectando a startups de deep tech y egresados de facultades de ciencias de la computación con empresas de sectores tradicionales —como el agropecuario (AgTech), la industria farmacéutica, el transporte y el sector legal— que buscan automatizar sus procesos críticos sin entregar sus secretos comerciales a intermediarios de la nube global.
5. Hoja de Ruta Técnica: Transición hacia IA Soberana en 4 Pasos
Inspirados en las mejores prácticas promovidas en el congreso, los especialistas de Siglo 21 Soluciones aconsejan a las empresas trazar un camino gradual hacia la autonomía de cómputo:
- Auditoría de Sensibilidad de Datos y Dependencia de APIs: Clasificar todos los casos de uso de IA en la organización. Identificar qué flujos procesan datos confidenciales o regulados y calcular el gasto mensual recurrente en proveedores externos de modelos cerrados.
- Benchmarking de Modelos Abiertos de Nueva Generación: Evaluar en entornos de laboratorio el rendimiento de modelos abiertos (Llama-3, Mistral NeMo, Qwen-2.5) frente a las APIs propietarias para las tareas específicas de la compañía, midiendo exactitud, coherencia y velocidad de respuesta.
- Despliegue de Servidores Locales de Inferencia Contenerizada: Configurar un nodo o clúster de inferencia utilizando Docker, motores como vLLM u Ollama Enterprise y GPU passthrough, asegurando endpoints compatibles con la especificación de OpenAI para facilitar la migración sin alterar el código de las aplicaciones consumidoras.
- Afinamiento Especializado con Datos Propios (Fine-Tuning con LoRA): Aplicar técnicas de adaptación de bajo rango (LoRA) sobre el modelo base utilizando manuales internos, catálogos de productos y transcripciones de soporte, logrando un modelo propio altamente especializado que supere en precisión a los modelos genéricos comerciales.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor