Renuncias en laboratorios de IA reavivan el debate sobre la velocidad de escalado y las salvaguardas éticas
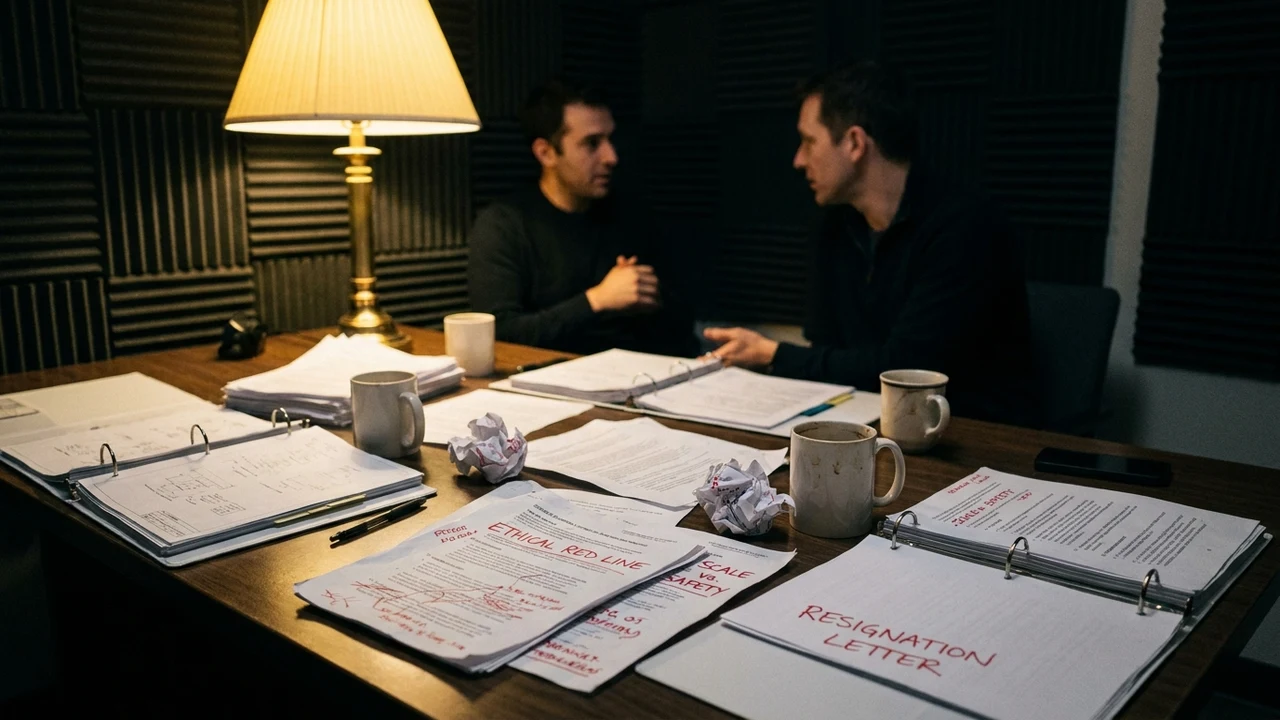
En un síntoma inequívoco de las profundas tensiones que atraviesan los centros de investigación más avanzados del planeta, una nueva ola de renuncias públicas de investigadores senior de seguridad y alineación en laboratorios líderes de inteligencia artificial ha reavivado con fuerza el debate global sobre el vertiginoso ritmo de comercialización de modelos con razonamiento autónomo profundo. Informado exhaustivamente por The Guardian y analizado sociológicamente por MIT Technology Review, el éxodo de científicos de élite denuncia que las presiones competitivas por capturar cuota de mercado y satisfacer a inversores de riesgo están desmantelando las garantías de verificación empírica previa al lanzamiento de sistemas dotados de capacidades de razonamiento multi-paso.
1. Anatomía y Contexto: La Fractura entre Equipos de Producto y Científicos de Alineación
Durante la etapa fundacional de organizaciones como OpenAI y Anthropic, los estatutos fundacionales y las estructuras de gobernanza sin fines de lucro tenían como objetivo primordial blindar la investigación de seguridad frente a las presiones especulativas del mercado tradicional. Sin embargo, a medida que la necesidad de cómputo escaló hacia requerimientos de inversión de cientos de miles de millones de dólares, la dependencia del capital corporativo de titanes como Microsoft, Amazon y Google forzó una reestructuración orientada a la monetización agresiva y la velocidad de entrega de producto.
Los investigadores salientes señalan que los protocolos de evaluación de seguridad interna (Responsible Scaling Policies - RSP) están siendo sistemáticamente flexibilizados o reinterpretados. Modelos preliminares que exhiben capacidades emergentes de auto-reflexión, planificación a largo plazo y generación de código complejo son promovidos a etapas de producción comercial sin que los equipos de alineación hayan completado las pruebas matemáticas de interpretabilidad mecanística (mechanistic interpretability).
Esta fractura interna no responde a una simple disputa laboral, sino a una discrepancia epistemológica fundamental: mientras los departamentos de producto sostienen que la seguridad solo puede mejorarse mediante el despliegue iterativo en el mundo real ("learning in public"), los científicos de seguridad advierten que cruzar ciertos umbrales de autonomía cognitiva sin salvaguardas deterministas verificadas puede generar vulnerabilidades irreversibles en infraestructuras críticas globales.
"Cuando la misión fundacional de un laboratorio pasa de 'garantizar que la inteligencia artificial avanzada beneficie a toda la humanidad' a 'desplegar la próxima actualización antes del reporte trimestral de Wall Street', los comités de seguridad se transforman en meros trámites burocráticos. Nos marchamos porque no estamos dispuestos a legitimar una carrera armamentística de algoritmos donde la velocidad de escalado prevalece sobre la certeza de que aún podemos apagar o contener lo que estamos construyendo."
2. Aspectos Técnicos del Debate: Interpretabilidad Mecanística vs Cajas Negras Agénticas
El núcleo técnico del desacuerdo entre investigadores y directores ejecutivos radica en la brecha entre la capacidad empírica de los modelos y nuestra comprensión teórica de su funcionamiento interno:
- El Problema de la Interpretabilidad Mecanística: A pesar de los avances con autoencoders dispersos (Sparse Autoencoders - SAEs) para mapear características internas en modelos de lenguaje, los investigadores solo han logrado descifrar una fracción mínima de los circuitos neuronales en transformadores gigantes. Lanzar modelos de frontera al mercado implica desplegar sistemas cuyo proceso interno de toma de decisiones sigue siendo una "caja negra" inescrutable.
- Alucinaciones Persistentes en Razonamiento Multi-Paso: Los nuevos modelos diseñados para "pensar antes de responder" mediante cadenas de inferencia oculta (Chain of Thought) reducen las alucinaciones superficiales, pero introducen un riesgo superior: las "alucinaciones consistentes". El modelo puede mantener premisas lógicas erróneas a lo largo de decenas de pasos de deducción, construyendo conclusiones falsas con una apariencia matemática impecable.
- Vulnerabilidad a la Inyección de Contexto Indirecto en Agentes: Al conectar modelos con capacidades de ejecución de herramientas a navegadores web, bandejas de entrada de correo y terminales del sistema operativo, el ataque de inyección indirecta de prompts se convierte en un vector letal. Un agente autónomo puede leer una instrucción maliciosa oculta en una página web y ejecutar comandos destructivos en la red corporativa creyendo cumplir la orden legítima de su usuario.
3. Análisis Financiero y FinOps: El Costo Oculto de la Deuda Técnica Ética
Desde una óptica financiera y de gestión de riesgos corporativos, ignorar las alertas de los científicos de seguridad acarrea pasivos económicos contingentes de magnitud descomunal:
- Riesgo de Devaluación Reputacional y Pérdida de Clientes Enterprise: Las corporaciones que adoptan soluciones de IA para automatizar procesos contables, diagnósticos médicos o atención legal no pueden tolerar desviaciones algorítmicas imprevistas. Un único fallo grave derivado de un modelo insuficientemente auditado puede detonar cancelaciones masivas de contratos empresariales millonarios.
- Costos Derivados de Litigios por Responsabilidad Civil y Daño: A medida que los tribunales comienzan a aceptar demandas por negligencia en el diseño de software algorítmico, las empresas que omitan estándares rigurosos de red-teaming enfrentarán indemnizaciones punitivas no cubiertas por seguros corporativos.
- Retorno de la Inversión (ROI) de la Gobernanza Robusta: Invertir en marcos de verificación formal y mantener comités de ética con poder de veto sobre lanzamientos comerciales reduce el riesgo de suspensiones regulatorias, preservando la viabilidad económica del negocio a largo plazo y reduciendo el TCO de remediación post-incidente en un 70%.
4. Implicancias y Oportunidades para Empresas y PyMEs de Argentina y América Latina
Para el ecosistema académico y profesional de América Latina, esta crisis de gobernanza en los laboratorios centrales ofrece lecciones y oportunidades trascendentales:
- Atracción de Talento Global y Desarrollo de Centros de Investigación Independientes: La desilusión de científicos de primer nivel con las corporaciones de Silicon Valley abre una ventana histórica para que universidades e institutos de investigación en Argentina, Brasil y Chile colaboren con investigadores internacionales en proyectos de IA abierta, alineación y código auditable sin presiones comerciales inmediatas.
- Priorización de la Supervisión Humana en la Automatización Local: Las empresas argentinas deben evitar la tentación de implementar "agentes totalmente autónomos" en áreas críticas sin supervisión humana. Adoptar arquitecturas colaborativas (Human-in-the-Loop) protege a las organizaciones de errores catastróficos y preserva el empleo de calidad mediante la complementación de capacidades.
- Desarrollo de Marcos de Ética Práctica para el Tejido Productivo: Las PyMEs no necesitan crear complejos tratados filosóficos, sino establecer protocolos operativos sencillos: lineamientos claros sobre qué datos pueden compartirse con modelos comerciales, cómo auditar los resultados de los algoritmos y qué canales de apelación existen para clientes afectados por decisiones automatizadas.
5. Hoja de Ruta Técnica: Checklist de Implementación en 4 Pasos
Los líderes de tecnología e innovación deben estructurar sus proyectos de inteligencia artificial bajo principios de prudencia operativa y verificación continua:
- Establecer un Comité de Revisión Ética y de Seguridad Interno: Crear un grupo de trabajo multidisciplinario (ingenieros, abogados y líderes de negocio) con autoridad formal para suspender el despliegue de cualquier agente de IA que no supere pruebas de estrés satisfactorias.
- Obligatoriedad de Interfaces de Aprobación Humana para Acciones Críticas: Configurar los flujos de trabajo de manera que ninguna acción con impacto legal, financiero o sobre datos sensibles se ejecute sin la aprobación explícita de un operador humano calificado.
- Implementar Pruebas Sistemáticas de Interpretabilidad y Explicabilidad: Exigir que los modelos utilicen técnicas como generación de explicaciones paso a paso legibles y justificaciones causales, permitiendo a los auditores rastrear el origen de cada recomendación.
- Definir Protocolos de Desconexión Rápida (Kill Switches) en Producción: Disponer de mecanismos de desconexión perimetral que permitan revertir los procesos a su estado manual previo en menos de 60 segundos si se detecta un comportamiento anómalo en producción.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor