PostgreSQL 19 formaliza el almacenamiento columnar nativo para analítica híbrida transaccional (HTAP)
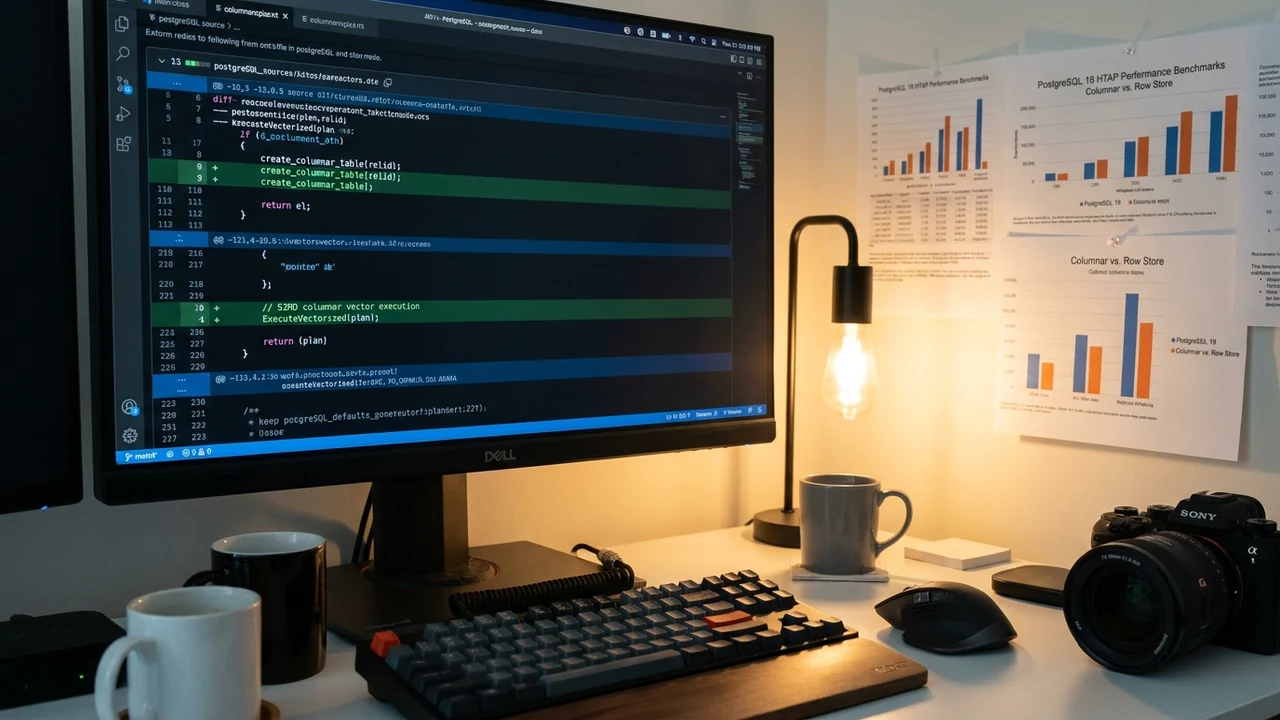
En lo que marca un hito histórico para la comunidad de bases de datos de código abierto, el PostgreSQL Global Development Group ha oficializado la incorporación de un motor de almacenamiento columnar nativo en el núcleo de PostgreSQL 19. La hoja de ruta y especificación formal, divulgada a través de PostgreSQL Development Group — Native Columnar Engine Roadmap and RFC y detallada exhaustivamente por Database Trends and Applications — The Evolution of HTAP in Modern PostgreSQL, habilita el procesamiento analítico y transaccional híbrido (HTAP) sin requerir extensiones externas propietarias. Esta arquitectura permite combinar tablas transaccionales por filas orientadas a escrituras OLTP de baja latencia con particiones columnares comprimidas mediante vectorización SIMD (AVX-512 y ARM Neon), acelerando consultas analíticas de business intelligence hasta 80 veces y reduciendo la huella de almacenamiento físico hasta un 75%.
1. Anatomía y Contexto: La Fractura Histórica entre Sistemas OLTP y OLAP
Durante más de tres décadas, las arquitecturas de datos empresariales se vieron obligadas a dividirse en dos mundos tecnológicos desconectados: los motores transaccionales orientados a filas (como PostgreSQL tradicional, MySQL u Oracle), diseñados para inserciones y actualizaciones rápidas registro por registro, y los almacenes de datos analíticos orientados a columnas (como Snowflake, ClickHouse o BigQuery), optimizados para agregar miles de millones de registros sobre pocas columnas específicas. Esta bifurcación forzó la proliferación de tuberías ETL (Extracción, Transformación y Carga) complejas, lentas y propensas a fallos de sincronización y duplicación de datos.
El auge de la analítica en tiempo real y la toma de decisiones automatizada por inteligencia artificial volvieron intolerable la latencia de las tuberías ETL por lotes. Los intentos previos de dotar a PostgreSQL de capacidades columnares dependían de extensiones de terceros (como cstore_fdw o Hydra), las cuales carecían de integración plena con el planificador de consultas de costos (cost-based optimizer), el catálogo central de estadísticas y el registro de transacciones de escritura previa (Write-Ahead Logging - WAL). Con PostgreSQL 19, el motor columnar se convierte en un subsistema de tabla nativo (Table Access Method), permitiendo declarar tablas o particiones analíticas mediante una directiva estándar USING columnar, manteniendo total compatibilidad ACID y posibilitando consultas analíticas masivas sobre los mismos datos operativos.
"La separación forzada entre bases de datos transaccionales y almacenes analíticos ha sido una pesada carga de complejidad operativa para la industria del software. Al formalizar el almacenamiento columnar dentro del núcleo de PostgreSQL 19, permitimos a los ingenieros ejecutar transacciones ACID de alta concurrencia y consultas complejas de agregación sobre el mismo clúster, con optimización vectorial SIMD y compresión de nivel de diccionario transparente."
2. Arquitectura Técnica y Mecanismos del Motor Columnar Nativo
El nuevo motor columnar de PostgreSQL 19 introduce componentes internos diseñados para extraer el máximo provecho de las arquitecturas de CPU y memorias contemporáneas:
- Formato de Bloque Stripe y Chunking Vectorizado: En lugar de páginas fijas de 8 KB por fila, las tablas columnares agrupan datos en fragmentos denominados stripes de hasta 64 MB. Cada columna se divide en chunks homogéneos comprimidos individualmente con algoritmos ZSTD, LZ4 y compresión por longitud de ceros (Run-Length Encoding - RLE).
- Ejecución Vectorizada con Instrucciones SIMD: Los operadores de escaneo y filtrado analítico procesan bloques de 1.024 valores por ciclo mediante instrucciones AVX-512 en procesadores x86-64 y ARM Neon en procesadores Apple Silicon y Graviton, evaluando condiciones
WHEREdirectamente sobre datos comprimidos sin descompresión previa en memoria. - Mapeo de Bloques de Metadatos y Skip Indexes: Cada bloque columnar almacena metadatos de rango (valores mínimos y máximos) en memoria caché. Durante escaneos masivos, el planificador salta automáticamente el 90% de los bloques irrelevantes (block pruning), minimizando lecturas innecesarias en almacenamiento NVMe.
- Integración Plena en el Planificador de Consultas y WAL: A diferencia de las extensiones externas, el motor columnar genera estadísticas multivariadas en
pg_statistic, participa en transacciones distribuidas de dos fases y replica sus cambios de manera atómica a través del flujo binario WAL estándar a réplicas de lectura.
3. Análisis Financiero, FinOps y Retorno de Inversión (CapEx/OpEx)
La formalización del paradigma HTAP nativo en PostgreSQL produce un ahorro de costos sustancial para los departamentos de tecnología y finanzas:
- Eliminación de Costos de Licenciamiento y Nube de Almacenes OLAP: Las compañías medianas que pagan entre USD 60.000 y USD 150.000 anuales por instancias de data warehouses analíticos dedicados en la nube pueden consolidar hasta el 80% de sus cargas analíticas en sus propios clústeres PostgreSQL existentes sin costo adicional de software.
- Ahorro del 70% en Almacenamiento NVMe y Salida de Red: Gracias a los algoritmos de compresión columnar de nivel de producción, un volumen transaccional de 10 Terabytes se compacta a menos de 2,5 Terabytes, disminuyendo drásticamente el aprovisionamiento de almacenamiento EBS/SSD y los costos de transferencia entre zonas de disponibilidad.
- Reducción de Deuda Técnica y Horas de Ingeniería en ETL: La supresión de tuberías complejas de replicación ahorra en promedio 30 horas semanales de mantenimiento de datos por equipo de ingeniería de datos, liberando recursos para iniciativas analíticas de valor comercial directo.
4. Implicancias y Oportunidades para Empresas y PyMEs en Argentina y América Latina
Para el ecosistema corporativo en Argentina —en ciudades como Buenos Aires, Córdoba, Rosario y Paraná—, la llegada de PostgreSQL 19 democratiza la inteligencia de negocios en tiempo real:
En el sector del Comercio Electrónico y Retail Omnicanal, las plataformas de ventas minoristas y billeteras digitales pueden ejecutar tableros de control de ventas, análisis de abandono de carritos y conciliación de saldos instantáneos sobre la misma base de datos operativa, sin sufrir bloqueos transaccionales ni retrasos en la disponibilidad de la información para la toma de decisiones comerciales.
En la Agroindustria y Cadena de Suministros de Santa Fe y Entre Ríos, los exportadores de cereales y molinos procesan millones de registros de telemetría de fletes, pesaje de camiones y análisis de humedad de granos. PostgreSQL 19 permite retener años de historial agronómico comprimido en el mismo servidor de balanza local, permitiendo consultas analíticas de series temporales sin depender de costosas conexiones satelitales a nubes públicas.
5. Hoja de Ruta y Checklist de Implementación Técnica en 4 Pasos
Para migrar esquemas transaccionales hacia arquitecturas híbridas HTAP en PostgreSQL 19, los especialistas de Siglo 21 Soluciones recomiendan el siguiente plan de acción:
- Paso 1: Identificación y Clasificación de Cargas Transaccionales y Analíticas: Analizar los registros de actividad mediante
pg_stat_statementspara identificar tablas con consultas pesadas de agregación (SUM,AVG,GROUP BY) sobre millones de registros históricos que conviven con escrituras transaccionales. - Paso 2: Implementación de Particionado Híbrido Fila/Columna: Diseñar un esquema de particionado por rangos de fechas donde las particiones recientes del mes en curso utilicen almacenamiento de filas (
USING heap) y las particiones consolidadas migren automáticamente aUSING columnarcon compresión ZSTD. - Paso 3: Sintonización de Instrucciones Vectoriales y Caché de Bloques: Calibrar los parámetros
columnar.stripe_size = 32MBycolumnar.vector_batch_size = 1024enpostgresql.conf, asegurando que los binarios compilen con soporte nativo para el conjunto de instrucciones AVX-512 o ARM Neon del procesador. - Paso 4: Auditoría de Consultas y Comparativa de Rendimiento: Evaluar las consultas analíticas críticas mediante
EXPLAIN ANALYZEpara verificar la activación del operador Vectorized Columnar Scan y medir la reducción en tiempos de latencia y uso de buffers de memoria compartida.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor