OpenAI completa el diseño de su primer chip propio de inferencia tras 20 meses de desarrollo asistido por IA
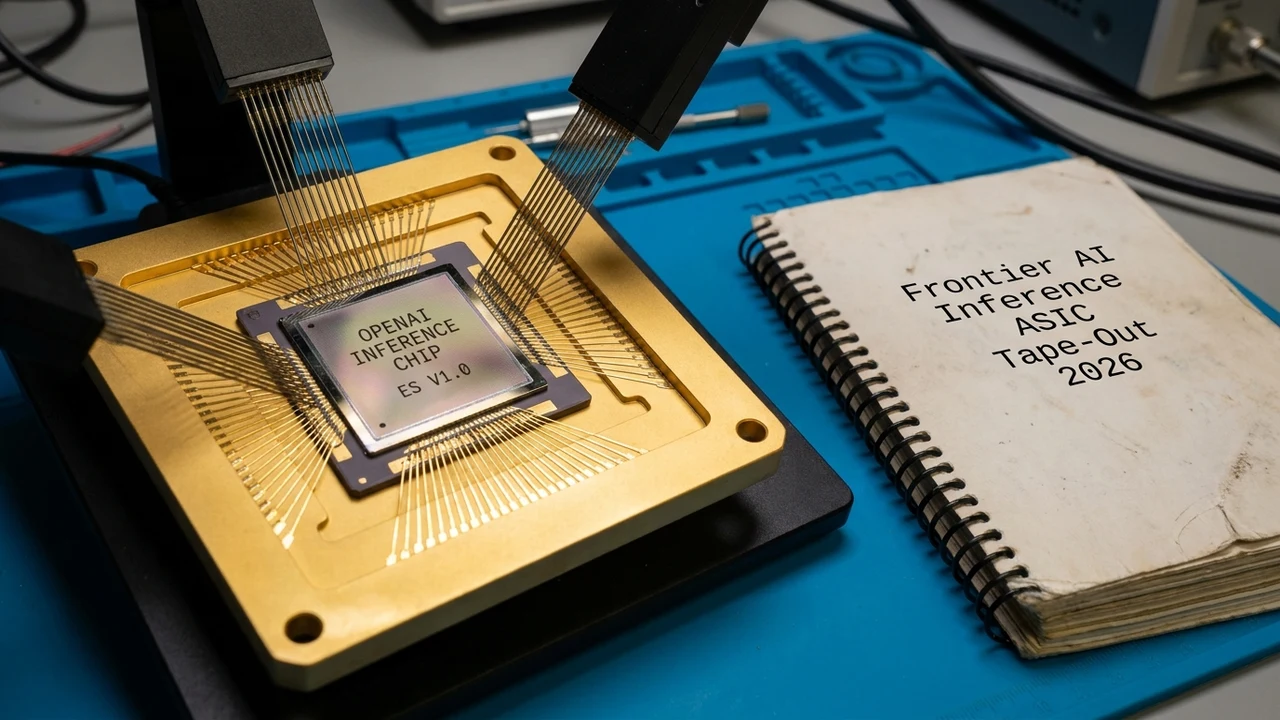
En un giro estratégico determinante para el equilibrio de poder de la industria tecnológica, OpenAI completó con éxito el diseño final y el envío a fundición (tape-out) de su primer chip ASIC propio dedicado exclusivamente a la inferencia de modelos masivos. Tras 20 meses de desarrollo confidencial en alianza con firmas especializadas como Broadcom y utilizando herramientas de síntesis física automatizadas asistidas por sus propios modelos de lenguaje, la organización da el paso definitivo para mitigar su asfixiante dependencia de proveedores externos de GPU y abaratar drásticamente el costo energético de procesar millones de consultas simultáneas, según revelaron investigaciones publicadas por The Information y la revista especializada EE Times.
1. Anatomía y contexto de la noticia: El imperativo del silicio a medida
Durante los primeros compases del auge de la inteligencia artificial generativa, el mercado operó bajo una premisa sencilla: adquirir la mayor cantidad posible de GPUs de propósito general comercializadas por Nvidia. Sin embargo, a medida que los modelos de frontera maduraron y el volumen operativo mutó desde la fase de entrenamiento (entrenar un modelo durante meses) hacia la fase de inferencia perpetua (servir a cientos de millones de usuarios y flujos agenticos cada segundo), la ineficiencia económica y térmica de utilizar silicio generalista se convirtió en una amenaza existencial.
Una GPU para centros de datos está diseñada con una flexibilidad extrema: incorpora circuitería para renderizado 3D, cálculos en coma flotante de doble precisión (FP64), trazado de rayos por hardware y canalizaciones gráficas que resultan completamente inútiles cuando la única tarea requerida consiste en multiplicar matrices dispersas en baja precisión y ejecutar atención con memoria KV-cache. Esta sobrecarga funcional se traduce en un consumo eléctrico desmedido y un costo unitario por acelerador prohibitivo.
El procesador de OpenAI, concebido bajo la dirección de un equipo de veteranos reclutados de Apple, Google TPU y Marvell, apunta directamente a optimizar el rendimiento por vatio en cargas de razonamiento paso a paso (reasoning models tipo o-series). Al prescindir de componentes superfluos, el microcircuito maximiza el área de silicio dedicada a núcleos tensores compactos y ancho de banda local hacia memorias ultrarrápidas, redefiniendo las economías de escala de la inferencia.
"El futuro de los grandes modelos de razonamiento no se librará únicamente en los algoritmos de software o en la curaduría de datos, sino en los transistores a nivel microscópico. Desarrollar silicio adaptado matemáticamente a nuestra propia arquitectura de transformadores es la única vía viable para escalar la inteligencia artificial a escala planetaria sin devorar la red eléctrica del mundo."
2. Arquitectura técnica profunda: Síntesis con EDA asistida por IA y diseño específico
El desarrollo de este procesador representa un hito no solo por su destino operativo, sino por la metodología con la que fue concebido, marcando la consolidación de la inteligencia artificial cerrando el ciclo de creación de su propio hardware:
- Automatización del Floorplanning y Ruteo Físico con Modelos Generativos: Tradicionalmente, el diseño de un chip complejo insume más de tres años y cientos de ingenieros de automatización del diseño electrónico (EDA). OpenAI empleó modelos de refuerzo y LLMs especializados integrados con herramientas de Synopsys y Cadence para optimizar el floorplanning (distribución espacial de macrobloques), reduciendo las rutas críticas de reloj y minimizando la inductancia parásita en un 40% del tiempo habitual.
- Unidades de Procesamiento de Atención Dedicadas (APUs): A diferencia de las arquitecturas tradicionales que dependen de accesos recurrentes a memoria DRAM externa para calcular matrices de clave-valor (KV Cache), el ASIC de OpenAI integra un banco masivo de memoria estática SRAM directamente en la matriz (on-chip) de más de 128 Megabytes por núcleo, permitiendo resolver la atención contextual local sin salir al bus de interconexión.
- Soporte Nativo de Precisión Arbitraria Microscaling (MXFP4 y MXFP6): El silicio implementa en hardware los estándares OCP Microscaling Formats, operando nativamente en representaciones numéricas de 4 y 6 bits con bloques de escala compartidos. Esto cuadruplica el rendimiento computacional de operaciones de punto flotante por vatio consumido frente a arquitecturas FP16 convencionales.
- Interconexión Óptica y Coherencia de Memoria: El diseño contempla puertos de interconexión óptica empaquetada (CPO - Co-Packaged Optics) con protocolos ultra-baja latencia para permitir que clústeres de hasta 256 aceleradores operen como un único espacio de memoria unificada virtual.
3. Análisis financiero y FinOps cuantitativo: Inversión en diseño vs. ahorro en escala
Diseñar un chip avanzado en litografía de vanguardia demanda una inversión colosal de capital, pero para una empresa con el volumen de inferencia de OpenAI, los números cierran con una velocidad asombrosa:
- CapEx de Desarrollo Inicial (NRE y Tape-Out): Los costos de ingeniería no recurrente (NRE), licencias de propiedad intelectual (IP cores de interconexión PCIe y SerDes), software EDA y la fabricación de máscaras litográficas para un nodo de 3nm superan holgadamente los USD 350 millones a USD 500 millones.
- Reducción Radical de Costo Marginal por Token (OpEx): El costo de fabricación de un ASIC personalizado ronda los USD 3.000 a USD 4.500 por unidad montada en placa de circuito impreso, comparado con el precio de mercado de entre USD 30.000 y USD 40.000 de una GPU de gama alta comercial. Más relevante aún: la reducción del consumo térmico (de 700W a aproximadamente 320W por zócalo para idéntica tasa de tokens) reduce los costos de refrigeración y energía eléctrica en centros de datos en más de un 52%.
- Período de Amortización (Payback): Considerando que OpenAI gasta miles de millones de dólares anuales en alquilar capacidad de cómputo en la nube de Microsoft Azure, el despliegue de sus primeros 100.000 aceleradores propios amortiza la totalidad del gasto de desarrollo en menos de 14 meses de operación comercial intensiva.
4. Implicancias y oportunidades para empresas y PyMEs de Argentina y América Latina
La irrupción de procesadores propietarios diseñados por los proveedores líderes de modelos altera el panorama de costos para todas las organizaciones que consumen APIs de inteligencia artificial en Argentina y la región. Históricamente, las empresas locales han sufrido el impacto de tarifas en dólares que aumentaban la estructura de costos frente a la depreciación monetaria y restricciones de pago al exterior:
A medida que la inferencia se abarata en el origen gracias a estos ASICs específicos, la presión sobre las tarifas por millón de tokens continuará cayendo drásticamente. Lo que en 2024 costaba 15 dólares por millón de tokens de entrada en modelos avanzados, tenderá a fraccionarse hacia centavos de dólar. Esto democratiza la adopción de agentes de atención al cliente autónomos, asistentes contables y análisis legal automatizado para PyMEs argentinas que anteriormente veían inviables estos costos recurrentes.
Por otra parte, este movimiento confirma que la verdadera ventaja competitiva de las empresas no radicará en poseer hardware físico, sino en la capacidad de diseñar pipelines de datos limpios, integrar APIs de manera eficiente y gobernar la seguridad de la información a nivel aplicativo.
5. Hoja de ruta técnica: Checklist de implementación en 4 pasos
- Auditoría de Consumo de Tokens y Arquitectura de Inferencia (Paso 1): Analizar los registros de tráfico de las aplicaciones corporativas para desglosar el gasto en APIs de inferencia según modelo y ventana de contexto. Identificar tareas complejas de razonamiento versus tareas rutinarias de formateo de texto.
- Implementación de Enrutamiento Dinámico de Modelos (Model Routing) (Paso 2): Configurar una capa intermedia (API Gateway) que derive las solicitudes sencillas hacia modelos compactos altamente optimizados y reserve los modelos de razonamiento profundo únicamente para casos excepcionales que demanden lógica matemática o deducción jurídica.
- Optimización de Caché de Contexto (Prompt Caching) (Paso 3): Aprovechar los mecanismos de almacenamiento en caché de prefijos ofrecidos por los proveedores, reduciendo hasta un 80% el costo de tokens de entrada repetitivos en manuales operativos, bases de conocimiento y catálogos de productos.
- Integración con Protocolos Abiertos y Asesoría Especializada (Paso 4): Desacoplar la lógica de negocio del proveedor de IA subyacente utilizando interfaces estandarizadas y consultando a los especialistas de Siglo 21 Soluciones para implementar arquitecturas de software inteligentes, rentables y preparadas para los continuos saltos de hardware.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor