NVIDIA y TSMC anuncian la arquitectura de empaquetado CoWoS-L de próxima generación para aceleradores Rubin
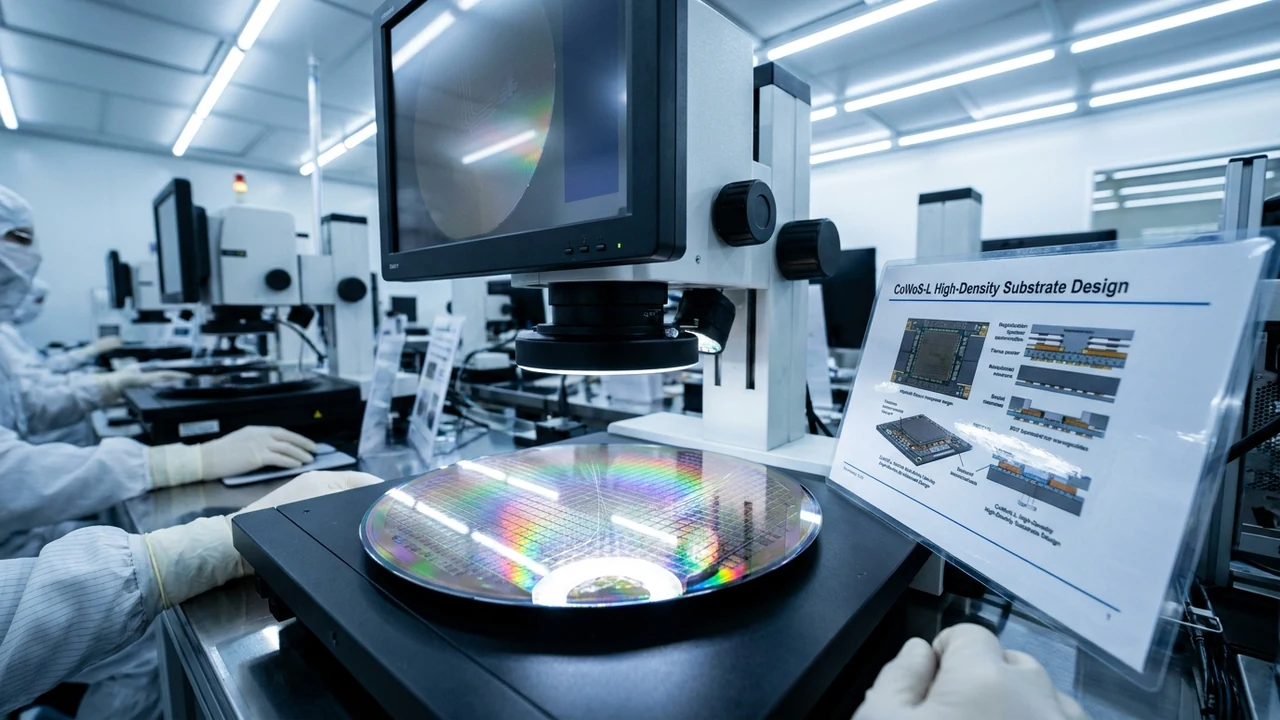
En una demostración conjunta de liderazgo en la industria de semiconductores, NVIDIA y TSMC han revelado la evolución técnica de su tecnología de empaquetado CoWoS-L (Chip-on-Wafer-on-Substrate with Local Silicon Interconnect), optimizada específicamente para la esperada arquitectura de aceleradores Rubin. Tal como revelan los informes presentados en el TSMC Technology Symposium — 3D Interconnect Innovations for Next-Gen AI Silicon y cubiertos por EE Times — Advanced Packaging Breakthroughs in High-Bandwidth AI Clusters, esta plataforma multiplica por cuatro el ancho de banda efectivo entre las matrices lógicas y las pilas de memoria de ultra-alta velocidad HBM4. Al sustituir las vías metálicas convencionales con puentes de interconexión y micro-redes de silicio pasivo, las compañías eliminan el cuello de botella físico de memoria que amenazaba con limitar el escalado de modelos fundacionales con más de 10 billones de parámetros.
1. Anatomía y Contexto: El Fin del Escalado Monolítico y el Triunfo del Empaquetado Avanzado
Durante décadas, la Ley de Moore avanzó a través de la reducción geométrica de los transistores en obleas monolíticas. Sin embargo, en el umbral de los 2 y 1.6 nanómetros, las limitaciones litográficas impuestas por el tamaño de retícula estándar hicieron inviable construir procesadores de IA más grandes como un solo dado continuo. La respuesta de la industria ha sido la desagregación modular en chiplets interconectados en tres dimensiones, donde la innovación se desplaza hacia la ciencia de materiales y el empaquetado avanzado.
La colaboración entre NVIDIA y TSMC en torno a los futuros aceleradores Rubin (previstos para su despliegue hacia 2026-2027) representa la culminación de esta estrategia. CoWoS-L integra múltiples dies lógicos fabricados en el nodo N3P/N2 de TSMC junto a ocho o doce pilas verticales de memoria HBM4, asentadas sobre un intercalador orgánico de gran superficie con micro-puentes de silicio embebidos (LSI).
Esta topología física es indispensable para satisfacer la demanda de throughput requerida por el entrenamiento de modelos de razonamiento continuo. A medida que las matrices de atención crecen, el rendimiento ya no está acotado exclusivamente por los teraflops teóricos del chip, sino por la tasa de transferencia a la que los pesos sinápticos fluyen hacia las unidades de cómputo tensorial sin disipar calor excesivo.
"Hemos empujado los límites de la física del silicio más allá de cualquier predicción histórica. Con el nuevo CoWoS-L para Rubin, estamos creando un ecosistema de cómputo unificado donde la memoria HBM4 y los dies lógicos operan con la latencia y coherencia de un único procesador cuántico-electrónico continuo."
2. Arquitectura Técnica y Mecanismos Físicos: Intercalador RDL, Puentes LSI y HBM4
La especificación de la nueva generación CoWoS-L introduce innovaciones electro-ópticas determinantes:
- Multiplicación del Área de Intercalador: La superficie útil del sustrato supera los 4.500 mm², permitiendo alojar hasta 4 matrices de cálculo Rubin masivas y hasta 12 cúmulos de HBM4 con una densidad que excede las 100.000 micro-soldaduras por centímetro cuadrado.
- Transición a Capas de Redistribución (RDL) de Cobre Ultrafino: El intercalador orgánico reduce el estrés térmico diferencial y permite líneas de interconexión con un paso inferior a 0.4 micrones, disminuyendo la capacitancia parasitaria a frecuencias de gigahercios.
- Integración Nativa de Canales HBM4 con Bus de 2048 Bits: Cada interfaz de memoria HBM4 duplica el ancho de bus anterior, logrando un ancho de banda consolidado superior a los 20 Terabytes por segundo por zócalo de acelerador.
- Soporte para Co-Empaquetado Óptico (CPO): El nuevo sustrato prevé zócalos dedicados para motores fotónicos que convierten señales eléctricas en pulsos láser en el borde del módulo, mitigando pérdidas resistivas en interconexiones NVLink a nivel de rack.
3. Análisis Financiero, FinOps y Retorno de Inversión en Infraestructura de Supercómputo
El empaquetado avanzado redefine la estructura de gastos de capital (CapEx) y eficiencia energética (OpEx) para proveedores de nube:
- Inversión de Capital por Nodo de Cómputo (CapEx): Si bien el costo de un módulo acelerador CoWoS-L de última generación se estima entre USD 45.000 y USD 60.000 debido a la complejidad de fabricación, su densidad computacional reduce los racks requeridos en un 65% para un clúster de escala gigawatt.
- Eficiencia Operativa Energética (PUE y TCO): Gracias a la disminución de resistencias parásitas en los puentes LSI, la energía consumida cae a menos de 0.6 picojulios por bit transferido. Para un centro de datos de 50.000 GPUs, esto representa un ahorro anual superior a los USD 18 millones.
- Retorno de Inversión en Entrenamiento de Frontera: Al reducir el tiempo de entrenamiento de un modelo de 5 billones de parámetros de 120 días a 32 días, las organizaciones amortizan la inversión inicial en menos de un ciclo fiscal al ganar ventajas determinantes en comercialización.
4. Implicancias y Oportunidades para Empresas y PyMEs en Argentina y América Latina
Aunque América Latina no fabrica semiconductores de frontera, las ramificaciones de este avance impactan en el ecosistema regional:
- Disponibilidad de Capacidad Cloud y Descompresión de Costos: La aceleración en la producción de CoWoS-L amplía la oferta global de cómputo, propiciando bajas en tarifas de alquiler de GPUs de generaciones previas (H100, Blackwell) en nubes públicas para startups y universidades locales.
- Polos de Diseño Electrónico y Simulación de Materiales: Grupos de investigación del CONICET, el Instituto Balseiro y facultades de ingeniería en Santa Fe, Córdoba y CABA disponen de nuevas oportunidades para contribuir con patentes en diseño térmico y fotónica integrada.
- Optimización de Centros de Cómputo Locales: Empresas de telecomunicaciones e infraestructura deben diseñar sus datacenters con sistemas de refrigeración líquida directa al chip, preparándose para hardware que disipará más de 1.200 vatios por zócalo individual.
5. Hoja de Ruta y Checklist de Implementación Técnica en 4 Pasos
Para que los arquitectos de sistemas adopten eficazmente estas tecnologías emergentes, se recomienda la siguiente secuencia:
- Paso 1: Auditoría de Eficiencia de Memoria en Cargas de Trabajo: Perfilar aplicaciones de entrenamiento e inferencia mediante NVIDIA Nsight Systems para calcular el ratio FLOPS/Memory Bandwidth y determinar si el cuello de botella reside en memoria o en silicio.
- Paso 2: Planificación de Modernización Térmica e Hidráulica: Adecuar instalaciones de datacenter para incorporar refrigeración líquida dieléctrica capaz de soportar densidades térmicas superiores a 100 kW por rack.
- Paso 3: Adaptación de Software para Jerarquías Desagregadas: Optimizar núcleos de cálculo en Triton y CUDA para aprovechar primitivas de paralelismo de tensor adaptadas a canales de 2048 bits sin atascos de sincronización.
- Paso 4: Estrategia FinOps de Transición en Nube: Proyectar reservas contractuales plurianuales con proveedores cloud, planificando la migración paulatina hacia clústeres Rubin para capturar una reducción del 60% en costos por token.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor