Microsoft enfrenta incidentes masivos en Remote Desktop y autenticación de dominio tras las actualizaciones acumulativas
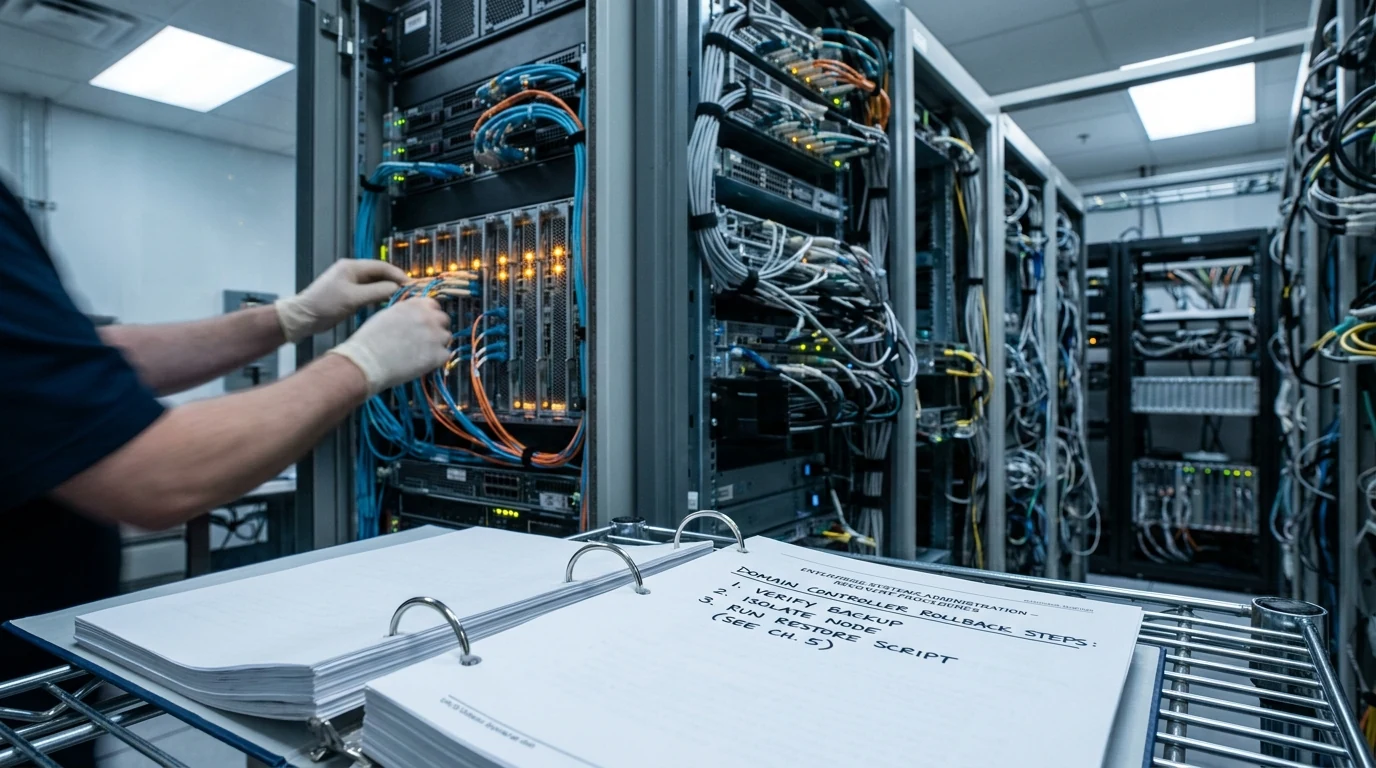
Administradores de sistemas y centros de datos de todo el mundo reportaron graves fallas operativas tras aplicar los últimos parches de seguridad acumulativos de Microsoft, provocando cuelgues espontáneos en consolas de gestión MMC, caídas en servicios de Remote Desktop (RDS) e interrupciones en la autenticación de controladores de dominio Windows Server.
La gestión de parches en infraestructuras corporativas críticas ha vivido una semana de máxima tensión para los administradores de sistemas a nivel internacional. Microsoft Corporation publicó hoy, domingo 20 de septiembre de 2026, una serie de avisos de contingencia y soluciones de contorno (workarounds) oficiales para mitigar una ola de incidentes masivos desatados por las actualizaciones de seguridad acumulativas del ciclo de septiembre en servidores Windows Server 2022, 2025 y estaciones de trabajo con Windows 11 Enterprise.
De acuerdo con miles de reportes documentados en foros de soporte corporativo y analizados por BleepingComputer, las actualizaciones diseñadas para corregir vulnerabilidades de escalada de privilegios en el protocolo de autenticación Kerberos introdujeron un error crítico de regresión en el servicio Local Security Authority Subsystem Service (LSASS). Este fallo provoca fugas de memoria en cascada y bloqueos en las sesiones remotas de Remote Desktop Services (RDS), impidiendo que miles de empleados y desarrolladores accedan a sus escritorios virtuales y provocando la parálisis temporal de consolas de gestión centrales (MMC) en centros de cómputo empresariales.
1. Causas Técnicas: Regresión en LSASS, Desalineación Kerberos y Solución de Contorno
El análisis de ingeniería de Microsoft identificó que la actualización acumulativa alteró de forma inadvertida el manejo de los tokens de autenticación mutua cuando un servidor de dominio negocia conexiones con clientes que poseen credenciales delegadas mediante CredSSP. Al producirse la renegociación periódica de la llave de sesión, el proceso `lsass.exe` entra en un bucle de contención de hilos que agota los recursos de la CPU y culmina en el reinicio forzado del controlador de dominio.
Mientras los equipos de ingeniería de Redmond finalizan una actualización de emergencia fuera de banda (Out-of-Band Update), Microsoft recomendó a los administradores de TI una solución de contingencia temporal: aplicar una modificación en el registro de Windows para deshabilitar temporalmente la directiva de aislamiento estricto de identidad en los hosts de sesión de escritorio remoto, o bien revertir selectivamente el paquete acumulativo conflictivo en aquellos servidores dedicados a granjas de terminales sin exponerlos a redes públicas no filtradas.
«Los administradores de sistemas enfrentan el dilema eterno de la ciberseguridad: aplicar parches para cerrar fallas críticas o congelar actualizaciones para evitar que los propios parches derrumben la operatividad del negocio; este incidente subraya la urgencia de entornos de homologación previa» — Lawrence Abrams, analista de infraestructura y director editorial de BleepingComputer
2. Lecciones de Continuidad Operativa y Buenas Prácticas para Equipos de TI
El incidente en Windows Server resalta la necesidad de protocolos de gestión de cambios inquebrantables:
- Prohibición Terminante de Parcheo Inmediato en Producción: Cualquier paquete de actualización acumulativa debe probarse al menos 72 horas en servidores de homologación idénticos.
- Estrategias de Despliegue Escalonado por Anillos (Ring Deployment): Actualizar primero un 5% de las máquinas secundarias antes de autorizar el despliegue a controladores de dominio centrales.
- Monitoreo de Procesos Críticos de Autenticación: Configurar alertas automáticas ante consumos de CPU superiores al 30% en el proceso `lsass.exe` de los servidores.
- Mantenimiento de Puntos de Restauración y Snapshots Verificados: Asegurar la capacidad de revertir una máquina virtual a su estado anterior en menos de 10 minutos ante fallas de arranque.
La disciplina metodológica en la administración de servidores es la única defensa real ante los fallos imprevistos de los grandes proveedores de software.
3. Análisis FinOps, Costos de Paradas de Servidores y Resiliencia Empresaria
Las caídas operativas en servicios de acceso remoto tienen un impacto económico inmediato:
- Costo de Downtime por Empleado Remoto Inactivo: Cada hora de parálisis de un servidor RDS que atiende a 100 profesionales genera pérdidas salariales directas de más de $15.000 USD.
- Sobrecarga en Mesas de Ayuda y Soporte Técnico: Los incidentes de bloqueo de credenciales saturan a los equipos de TI, retrasando proyectos estratégicos de la empresa.
- Ventajas de Arquitecturas Híbridas y Multi-Nube: Contar con mecanismos alternativos de acceso remoto basados en Linux o navegadores web garantiza la continuidad del negocio.
- Ahorro en Seguros de Interrupción Operativa: Las empresas que demuestran planes de contingencia documentados acceden a mejores condiciones en pólizas de riesgo tecnológico.
Para los directores de tecnología, la resiliencia consiste en diseñar arquitecturas que toleren la falla de cualquier componente individual sin detener la compañía.
4. Hoja de Ruta y Checklist de Implementación Técnica en 5 Fases
- Fase 1: Verificación de Parches Instalados en la Granja de Servidores: Identificar qué equipos recibieron las actualizaciones de septiembre y presentan consumos anómalos de memoria.
- Fase 2: Aplicación de la Solución de Contorno en el Registro: Ejecutar los comandos PowerShell recomendados por Microsoft para mitigar el conflicto de tokens en RDS.
- Fase 3: Aislamiento de Controladores de Dominio Afectados: Derivar las solicitudes de autenticación hacia nodos de respaldo secundarios que no hayan sido actualizados.
- Fase 4: Pruebas de Carga en Entorno de Laboratorio: Simular el ingreso masivo de usuarios para corroborar que las conexiones RDP se mantengan estables y fluidas.
- Fase 5: Despliegue del Parche de Emergencia Definitivo: Aplicar la corrección oficial fuera de banda de Microsoft una vez validada su estabilidad por la comunidad técnica.
¿Necesitás blindar y garantizar la continuidad operativa de tus servidores Windows y Linux?
En Siglo 21 Soluciones auditamos infraestructuras de misión crítica, controladores de dominio y esquemas de contingencia ante caídas.
Fuentes & Referencias Verificadas
¿Necesitás blindar y garantizar la continuidad operativa de tus servidores Windows y Linux?
En Siglo 21 Soluciones auditamos infraestructuras de misión crítica, controladores de dominio y esquemas de contingencia ante caídas.
Contactar a un Consultor