Microsoft y Nvidia consolidan estándares para la próxima generación de estaciones de trabajo con IA local
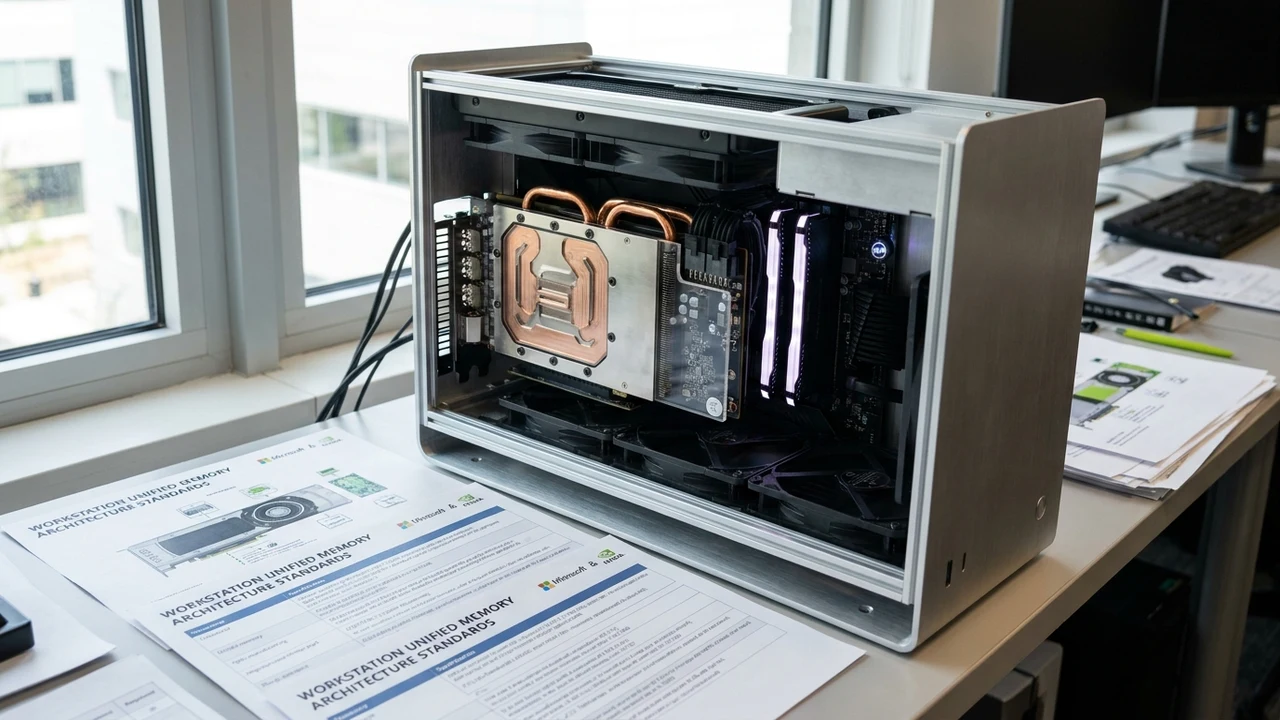
En una alianza de gran calado técnico que redefine la frontera de la microinformática profesional, Microsoft y Nvidia anunciaron un conjunto unificado de especificaciones de hardware y subsistemas de software para la próxima generación de estaciones de trabajo con IA local (Local AI Workstations). La iniciativa estandariza arquitecturas de memoria unificada de ultra-alto ancho de banda, buses de comunicación PCIe de sexta generación y extensiones directas del núcleo de Windows diseñadas para que desarrolladores, científicos de datos y arquitectos de ciberdefensa ejecuten modelos fundacionales de hasta 70.000 millones de parámetros (70B) en tiempo real directamente sobre sus computadoras de escritorio y servidores de oficina, garantizando privacidad absoluta de datos sin depender de enlaces a la nube pública, conforme a reportes de Windows Central y documentación de Nvidia Developer Blog.
1. Anatomía y contexto de la noticia: El repliegue desde la nube hacia el perímetro local
Durante los últimos cinco años, el dogma predominante en la industria tecnológica dictaminaba que cualquier carga de trabajo relacionada con modelos de aprendizaje profundo debía residir inevitablemente en centros de datos remotos hiperconectados. Sin embargo, a medida que las organizaciones comenzaron a incorporar inteligencia artificial en flujos de trabajo críticos que involucran código fuente propietario, historiales médicos confidenciales, patentes industriales y transacciones bancarias, las objeciones normativas de privacidad y los riesgos de filtración de datos provocaron una fuerte resistencia al uso exclusivo de infraestructuras SaaS públicas.
A estas consideraciones regulatorias se suma el desafío de la latencia determinista: ingenieros de software que utilizan asistentes de código en tiempo real o especialistas en visión artificial que procesan flujos de video de alta definición no pueden tolerar retrasos de red de cientos de milisegundos inherentes a enlaces transoceánicos o congestiones en servidores compartidos.
La respuesta conjunta de Microsoft y Nvidia unifica el ecosistema de fabricantes de equipos originales (OEMs como Lenovo, Dell, HP y Asus) en torno a especificaciones rigurosas que transforman las workstations convencionales en nodos de inferencia de alto rendimiento. Con esta iniciativa, las empresas pueden mantener sus activos de información estrictamente dentro de su red de área local (LAN) bajo un modelo de cómputo soberano y desconectado (air-gapped).
"Estamos cerrando la brecha entre el supercómputo de centros de datos y el puesto de trabajo del ingeniero. La combinación de núcleos Tensor de última generación, buses de interconexión directa y un subsistema de Windows diseñado para compilar tensores en microsegundos pone el poder de modelos de frontera en el escritorio de cada profesional, sin comprometer jamás la soberanía de sus datos confidenciales."
2. Arquitectura técnica profunda: Windows DirectML, arquitectura Blackwell Desktop y DMA
La convergencia anunciada descansa sobre pilares de ingeniería de hardware y optimizaciones a bajo nivel en el kernel del sistema operativo:
- Subsistema Unificado Windows ML y DirectML 2.0: Microsoft reconstruyó la capa DirectML para comunicarse directamente con los controladores de modo de usuario de Nvidia sin atravesar la sobrecarga de la pila gráfica de DirectX. Esto permite la ejecución de gráficos computacionales de tensores directamente en la memoria del dispositivo con accesos de acceso directo a memoria (DMA - Direct Memory Access) sin copiar datos a la memoria RAM del sistema anfitrión.
- Puente de Memoria Unificada LPDDR5X/GDDR7 con Ancho de Banda Terabyte: El estándar exige estaciones de trabajo configuradas con un mínimo de 128 Gigabytes de memoria VRAM combinada o esquemas de memoria unificada de bus ancho capaces de sostener tasas de transferencia superiores a 1,2 Terabytes por segundo. Esto resuelve el clásico obstáculo del ancho de banda de memoria que limitaba la inferencia de modelos 70B en configuraciones monousuario.
- Aceleración de FP4 y Transformadores con NVLink-C2C: En configuraciones de doble acelerador para escritorio, el puente NVLink-C2C (Chip-to-Chip) provee hasta 900 GB/s de ancho de banda bidireccional coherente entre tarjetas, permitiendo dividir capas de redes neuronales (tensor parallelism) con latencias insignificantes.
- Contenedores Seguros VBS y Enclaves de Confidencialidad: Para entornos corporativos altamente regulados, Windows habilita seguridad basada en virtualización (VBS) que aísla la memoria de ejecución del modelo en un enclave criptográfico protegido por hardware, impidiendo que procesos maliciosos o herramientas de volcado de memoria intercepten los pesos del modelo o las entradas del usuario.
3. Análisis financiero y FinOps cuantitativo: CapEx amortizable vs. costos recurrentes de API
Desde la perspectiva de la gestión financiera de tecnología de la información, el salto a estaciones de trabajo con IA local altera sustancialmente el perfil de costos de los departamentos de ingeniería y diseño:
- Inversión de Capital Inicial (CapEx de Estación de Trabajo): Una estación de trabajo certificada bajo este nuevo estándar (equipada con dos aceleradores RTX profesionales, 192 GB de memoria combinada, procesadores de 32 núcleos y almacenamiento NVMe Gen5) requiere una inversión de compra que oscila entre los USD 7.500 y USD 14.000 por puesto.
- Eliminación de Facturación Recurrente de Tokens (OpEx Cero por Uso): Un equipo de 10 desarrolladores senior que utiliza intensivamente modelos de IA para generación de código, refactorización y auditoría de seguridad consume habitualmente entre USD 1.800 y USD 3.500 mensuales en suscripciones corporativas y consumo de APIs en la nube. A este ritmo, la estación de trabajo local amortiza su costo de adquisición en menos de 12 a 18 meses, generando cómputo marginal gratuito e ilimitado a partir de ese período.
- Eficiencia Energética y Costo Eléctrico Operativo: A diferencia de los servidores de rack que exigen climatización industrial continua, estas estaciones de trabajo operan con perfiles de potencia dinámicos de entre 350W y 850W en plena carga, representando un costo eléctrico promedio inferior a USD 30 mensuales por puesto de trabajo en la mayoría de los cuadros tarifarios comerciales.
4. Implicancias y oportunidades para empresas y PyMEs de Argentina y América Latina
En el entorno económico de Argentina y los países vecinos, la estandarización de estaciones de trabajo con IA local ofrece una respuesta contundente a desafíos estructurales recurrentes. Las constantes oscilaciones en el tipo de cambio y las dificultades operativas para abonar suscripciones recurrentes en moneda extranjera hacen que los compromisos de gasto mensual en la nube representen una fuente de incertidumbre presupuestaria:
Adquirir equipamiento físico mediante líneas de crédito comercial, leasing tecnológico o reinversión de utilidades permite a las PyMEs argentinas transformar un costo operativo volátil e indexado al dólar en un activo de capital tangible amortizable fiscalmente según el régimen de ganancias local.
Asimismo, sectores como la industria legal, auditoría contable, estudios de arquitectura, desarrolladoras de software para terceros y agroindustria pueden garantizar a sus clientes que ningún dato estratégico abandona sus oficinas, cumpliendo estrictamente con la Ley de Protección de Datos Personales (Ley 25.326) y evitando riesgos de fuga de secretos comerciales.
5. Hoja de ruta técnica: Checklist de implementación en 4 pasos
- Evaluación de Perfiles de Puesto y Necesidades de Inferencia (Paso 1): Identificar los equipos técnicos y áreas operativas que generan el mayor volumen de consultas de IA o que manipulan información bajo estrictos acuerdos de confidencialidad (NDAs).
- Estandarización de Hardware y Verificación de Compatibilidad (Paso 2): Especificar compras de equipamiento que incluyan GPUs con un mínimo de 24 GB a 48 GB de VRAM (arquitecturas Ada Lovelace o Blackwell), placas base con soporte PCIe 5.0/6.0 y fuentes de alimentación certificadas 80 Plus Platinum para garantizar estabilidad operativa bajo cargas sostenidas.
- Despliegue del Entorno de Ejecución Local (Paso 3):
Configurar herramientas de servicio de inferencia local optimizadas (como Ollama, vLLM o LM Studio corporativo) integradas con subsistemas Windows WSL2 o DirectML nativo, vinculando los entornos de desarrollo (VS Code, Cursor) a endpoints locales seguros
localhost:11434. - Políticas de Seguridad y Acompañamiento Profesional (Paso 4): Establecer directrices de gobierno interno para la gestión de versiones de modelos de código abierto y recurrir a la experiencia de Siglo 21 Soluciones para auditar el despliegue de infraestructura local, garantizando máxima productividad y protección de activos intelectuales.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor