Matt Wood, CTO de AWS, anticipa la transición hacia clústeres de agentes autónomos impulsados por chips Trainium e Inferentia
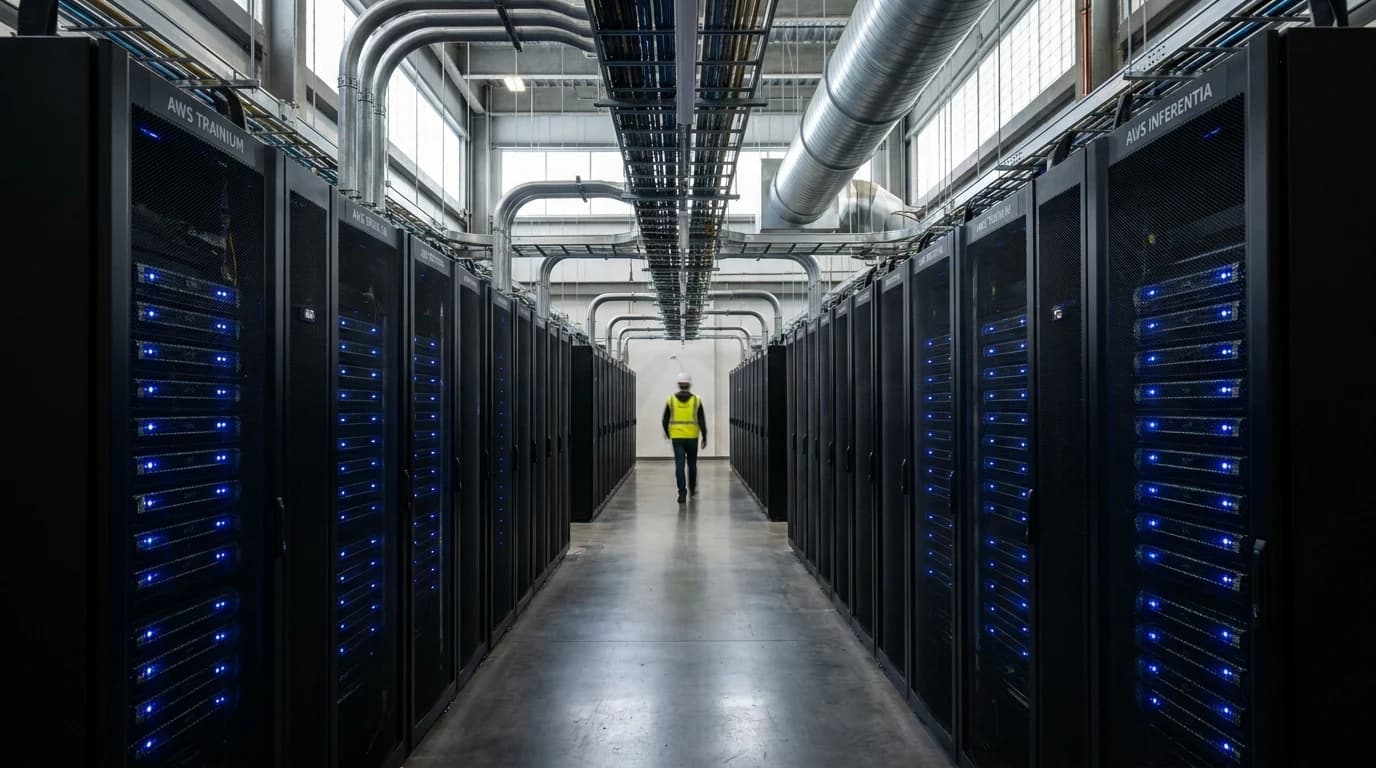
El director de tecnología de Amazon Web Services, Matt Wood, expuso la hoja de ruta de la compañía para la próxima era de la inteligencia artificial, anticipando que la hegemonía de los modelos monolíticos gigantes dará paso a clústeres masivos de agentes autónomos cooperativos acelerados por procesadores a medida como Trainium 3 e Inferentia.
La arquitectura computacional sobre la cual se edifica la inteligencia artificial global está atravesando una reconfiguración de proporciones tectónicas. En un extenso simposio tecnológico celebrado hoy, viernes 18 de septiembre de 2026, el vicepresidente de tecnología y flamante CTO de Amazon Web Services (AWS), Matt Wood, delineó la visión estratégica de la nube más grande del planeta para los próximos cinco años. Su tesis central marca un punto de inflexión en la industria: la obsesión por entrenar modelos monolíticos de billones de parámetros ha comenzado a mostrar rendimientos decrecientes, siendo superada por la eficiencia de clústeres distribuidos de pequeños agentes altamente especializados que colaboran en red.
Para sustentar este cambio de paradigma arquitectónico, Wood destacó el rol protagónico de los procesadores propietarios desarrollados por Annapurna Labs (el brazo de silicio de Amazon), específicamente los chips Trainium 3 e Inferentia 2.5. Estos aceleradores, concebidos desde el silicio para optimizar la transferencia de datos entre memoria y núcleos de cómputo con baja latencia y alta concurrencia, permiten orquestar enjambres de miles de agentes coordinados a una fracción del costo energético y financiero de las tarjetas GPU comerciales tradicionales.
1. Del Monolito Neuronal a los Enjambres de Agentes Cooperativos
Wood explicó que los desafíos del mundo empresarial no se resuelven con un modelo único que intente saberlo todo, sino con sistemas distribuidos donde agentes con diferentes roles y permisos resuelven partes de un problema. Un agente se especializa en análisis de código, otro en auditoría financiera, un tercero en validación de identidad y un cuarto en consolidación ejecutiva. Al interactuar mediante protocolos ligeros, el sistema global alcanza niveles de precisión y velocidad inalcanzables para un único modelo masivo.
Sin embargo, esta arquitectura agéntica impone exigencias técnicas inéditas a los centros de datos: una demanda masiva de ancho de banda entre chips (interconnect) y una bajísima latencia de respuesta para evitar cuellos de botella en la comunicación inter-agente. Es allí donde la infraestructura de AWS con enlaces ópticos NeuronLink de última generación y los aceleradores Trainium 3 marcan una ventaja competitiva decisiva, permitiendo que miles de agentes intercambien estados de memoria en microsegundos.
«La próxima frontera de la inteligencia artificial no consistirá en agregar más ceros a los parámetros de un modelo, sino en cómo orquestamos clústeres de agentes coordinados en silicio diseñado a medida para operar con máxima eficiencia energética y costos predecibles» — Matt Wood, Chief Technology Officer de Amazon Web Services, en la conferencia magistral citada por Amazon News
2. Eficiencia del Silicio Propio: Trainium vs. GPUs Comerciales
La apuesta de AWS por su propio hardware redefine los costos de infraestructura para empresas de software y proveedores cloud:
- Reducción de hasta un 50% en Costos de Inferencia: Las instancias basadas en Inferentia ofrecen un rendimiento por dólar significativamente superior al de tarjetas GPU de propósito general.
- Ahorro Energético y Sostenibilidad: Trainium 3 reduce la disipación térmica y el consumo eléctrico en un 40%, facilitando el cumplimiento de metas ambientales ESG.
- Integración Nativa con AWS Bedrock y SageMaker: Despliegue inmediato de agentes sin fricciones mediante SDKs estandarizados y bibliotecas de optimización Neuron.
- Garantía de Disponibilidad y Cero Fila de Espera: Al controlar la fabricación de sus propios chips, Amazon garantiza suministro continuo de capacidad sin demoras de proveedores externos.
Esta independencia en semiconductores permite a las organizaciones planificar su crecimiento tecnológico sin quedar a merced de la escasez global de componentes.
3. FinOps y Gobernanza de Cómputo para Arquitecturas Agénticas
La transición hacia redes de agentes exige a los líderes de finanzas y tecnología adoptar nuevas métricas de control presupuestario:
- Métricas de Costo por Tarea Agéntica Resuelta: Sustituir el monitoreo tradicional de utilización de vCPU por el costo total de computación necesario para completar un flujo de negocio.
- Optimización Mediante Enrutamiento Inteligente de Cargas: Derivar tareas simples de agentes a modelos ultraligeros en Inferentia y reservar chips pesados solo para deducción compleja.
- Contratos de Reserva con Descuentos Significativos: Aprovechar compromisos Compute Savings Plans en instancias Trainium con reducciones de hasta el 60% respecto a tarifas On-Demand.
- Monitoreo de Sobrecarga de Comunicación Inter-Agente: Auditar y optimizar los payloads JSON intercambiados para no saturar los enlaces de red de la nube.
El enfoque FinOps sobre silicio eficiente garantiza que la innovación agéntica impulse la rentabilidad de la compañía sin devorar sus márgenes comerciales.
4. Hoja de Ruta y Checklist de Implementación Técnica en 5 Fases
- Fase 1: Diagnóstico de Cargas de Trabajo y Separación Modular: Descomponer los flujos monolíticos de IA de la empresa en microservicios agénticos especializados.
- Fase 2: Pruebas de Compatibilidad con el SDK AWS Neuron: Compilar y evaluar los modelos de código abierto seleccionados sobre instancias de prueba basadas en Inferentia.
- Fase 3: Benchmarking de Latencia y Rendimiento Económico: Medir el throughput de inferencia por segundo y calcular el ahorro porcentual frente a GPUs convencionales.
- Fase 4: Orquestación de Agentes con Bedrock Agent Core: Conectar las herramientas, bases de datos y permisos de los agentes utilizando protocolos de comunicación segura.
- Fase 5: Despliegue Productivo con Auto-Scaling Dinámico: Configurar políticas de escalado automático para aprovisionar nodos Trainium según la demanda estacional de la empresa.
¿Necesitás optimizar la infraestructura de cómputo y servidores de tu organización?
En Siglo 21 Soluciones asesoramos en infraestructura de centros de datos, eficiencia energética y balanceo de cargas críticas de IA.
Fuentes & Referencias Verificadas
¿Necesitás optimizar la infraestructura de cómputo y servidores de tu organización?
En Siglo 21 Soluciones asesoramos en infraestructura de centros de datos, eficiencia energética y balanceo de cargas críticas de IA.
Contactar a un Consultor