Lambda Labs proyecta captar 4.000 millones de dólares para expandir clústeres de inferencia antes de su salida a bolsa
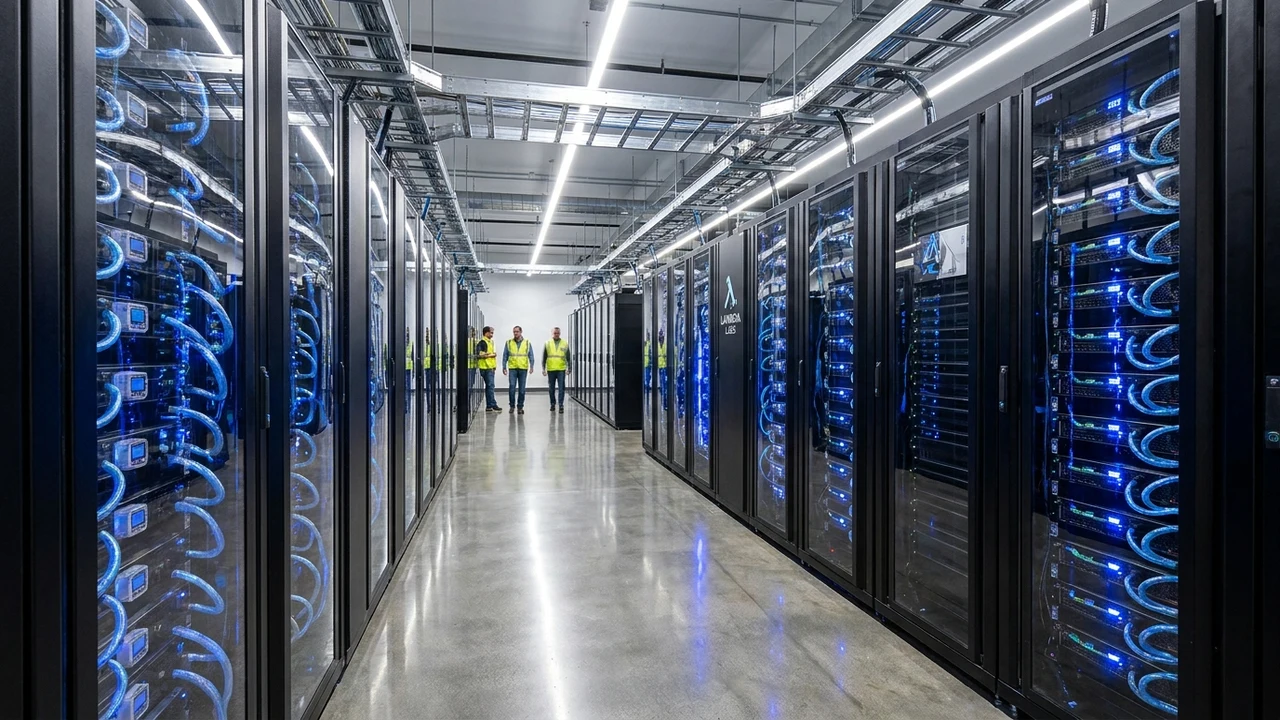
En una maniobra financiera de colosal envergadura que sacude el mercado global de infraestructura para inteligencia artificial, Lambda Labs, la proveedora especializada de cómputo en la nube respaldada estratégicamente por Nvidia, se encuentra en negociaciones avanzadas para captar una ronda de financiamiento previa a su oferta pública inicial (Pre-IPO) por 4.000 millones de dólares. Revelada por fuentes financieras en Bloomberg Markets y contextualizada por analistas energéticos en Data Center Knowledge, la inyección de capital estará destinada íntegramente a financiar la adquisición de más de 120.000 aceleradores de próxima generación y asegurar acuerdos de suministro eléctrico a largo plazo para centros de datos de hiperescala dedicados al servicio continuo de inferencia agéntica corporativa.
1. Anatomía y Contexto: La Transición del Entrenamiento Masivo a la Inferencia Persistente
Durante los primeros compases de la revolución de la IA generativa (2022-2024), el gasto de capital de la industria estuvo concentrado casi en su totalidad en clústeres de entrenamiento: infraestructuras diseñadas para procesar inmensos volúmenes de datos durante semanas o meses con el fin de producir los pesos de un nuevo modelo base. En 2026, la dinámica del mercado ha experimentado un vuelco determinante. Aunque los modelos de frontera continúan entrenándose, el consumo masivo y diario de computación proviene de la inferencia continua y los flujos de razonamiento multi-paso.
Los nuevos agentes autónomos, copilotos corporativos y sistemas de análisis en tiempo real demandan millones de horas de cálculo ininterrumpido. A diferencia de las cargas de entrenamiento tradicionales, la inferencia exige latencias predecibles, alta dispersión geográfica y una disponibilidad de red implacable con enlaces InfiniBand y Ethernet de ultra-alta velocidad.
Lambda Labs ha capitalizado esta coyuntura al posicionarse como la alternativa ágil y optimizada frente a los tres grandes hiperescalares (AWS, Azure y Google Cloud). Mientras los proveedores generalistas cargan con complejas capas de software heredado que elevan los costos de alquiler de máquinas virtuales, Lambda ofrece acceso directo ("bare-metal" y contenedores orquestados con Kubernetes) enfocado exclusivamente en cargas de trabajo de tensores, logrando eficiencias de costos de hasta un 40% por hora de GPU.
"El cuello de botella de la economía de la inteligencia artificial ya no es el algoritmo, sino los electrones y el silicio. Las empresas globales se están dando cuenta de que los hiperescalares tradicionales tienen márgenes excesivos y arquitecturas sobrecargadas para la inferencia de modelos agénticos. Esta ronda de 4.000 millones de dólares nos permitirá asegurar capacidad energética en firme y poner a disposición de los desarrolladores la mayor flota de aceleradores dedicados del planeta antes de nuestro debut bursátil en Wall Street."
2. Arquitectura Técnica de Infraestructura: Superclústeres de Inferencia y Enfriamiento Líquido
La magnitud de la expansión planificada por Lambda Labs impone desafíos de ingeniería térmica, eléctrica y de interconexión de redes sin precedentes en la industria:
- Arquitectura de Red de Baja Latencia RoCEv2 / Quantum-X: Para atender modelos con cientos de miles de millones de parámetros distribuidos mediante paralelismo de tensores (tensor parallelism), los clústeres integran conmutadores de 800 Gbps sin bloqueo con topologías Dragonfly+ y Fat-Tree, garantizando una latencia entre nodos inferior a 1,2 microsegundos.
- Refrigeración Líquida Directa al Chip (Direct-to-Chip Liquid Cooling): Con densidades térmicas que superan los 120 kilovatios por rack de servidores en los nuevos sistemas basados en Nvidia Blackwell B200 y Vera Rubin, los nuevos centros de datos prescinden del aire acondicionado tradicional, utilizando bucles cerrados de refrigeración líquida con intercambiadores de calor agua-agua (CDU) que reducen el índice de efectividad en el uso de energía (PUE) a un récord de 1,08.
- Plataformas de Orquestación Bare-Metal Efímeras: Lambda implementa un plano de control propio sobre Kubernetes que aprovisiona clústeres de cómputo en menos de 90 segundos mediante imágenes de contenedor pre-cacheadas en memorias NVMe-over-Fabrics (NVMe-oF), permitiendo a las organizaciones escalar elásticas ráfagas de inferencia ante picos de demanda transaccional.
- Monitoreo FinOps Predictivo de Consumo Energético: Sensores telemétricos en las barras colectoras de los racks alimentan modelos predictivos que ajustan dinámicamente las frecuencias de reloj de los procesadores gráficos según el costo spot del megavatio-hora en el mercado eléctrico mayorista, maximizando el rendimiento por vatio.
3. Análisis Financiero y FinOps: CapEx Titánico, Deuda Respaldada por GPUs y Múltiplos Pre-IPO
La estructuración de una ronda de 4.000 millones de dólares antes de salir a bolsa revela la sofisticación de la ingeniería financiera en la era de los semiconductores:
- Financiamiento Estructurado Respaldado por Activos de Silicio (Asset-Backed Debt): Una porción significativa de la ronda se estructura mediante vehículos de deuda sindicada respaldados por el valor residual de las propias GPUs adquiridas. Los inversores institucionales consideran a los aceleradores gráficos como activos líquidos de alta demanda, similares a flotas de aeronaves comerciales en el sector de aviación.
- Presión de CapEx vs Retorno de Flujo de Caja Libre: Adquirir más de 120.000 procesadores de alta gama junto con racks e infraestructura eléctrica demanda una absorción de capital colosal que mantendrá el flujo de caja libre en terreno negativo hasta mediados de 2027. Sin embargo, los contratos de reserva de capacidad a 3 y 5 años firmados con startups unicornio y corporaciones Fortune 500 garantizan ingresos futuros contratados que superan los USD 2.800 millones anuales.
- Múltiplos de Valuación y Arbitraje de Costos para Clientes: Para las empresas contratantes, migrar cargas de inferencia persistente desde nubes públicas tradicionales hacia clústeres dedicados de Lambda representa un ahorro operativo promedio de USD 140.000 mensuales por cada 100 GPUs reservadas, permitiendo optimizar sus balances de FinOps de forma inmediata.
4. Implicancias y Oportunidades para Empresas y PyMEs de Argentina y América Latina
El auge de proveedores de cómputo especializado como Lambda Labs tiene profundas repercusiones para la industria de desarrollo de software y startups de América Latina:
- Alivio a los Márgenes de Startups y Proveedores de Software (SaaS): Las empresas tecnológicas argentinas y de la región que construyen soluciones agénticas o servicios B2B sobre inteligencia artificial sufren el estrangulamiento de márgenes por el alto costo de las APIs de OpenAI o AWS. Acceder a clústeres de inferencia dedicados a costos significativamente menores permite a las startups locales ser rentables y competitivas a nivel internacional.
- Oportunidad de Arbitraje Energético en la Patagonia y Cuyo: La necesidad crítica de Lambda y otros operadores globales de encontrar emplazamientos con energía limpia y bajo costo térmico abre una oportunidad histórica para Argentina. Regiones como Neuquén (con gas de Vaca Muerta para generación en boca de pozo) o la Patagonia (con recursos eólicos de clase mundial) se perfilan como destinos ideales para atraer inversiones en centros de datos de IA.
- Adopción de Prácticas Maduras de FinOps en Equipos de Ingeniería: Las PyMEs tecnológicas de la región deben profesionalizar su monitoreo de costos de cómputo, implementando herramientas de medición de tokens por dólar y aprendiendo a negociar instancias reservadas y contratos spot en plataformas de cómputo alternativo.
5. Hoja de Ruta Técnica: Checklist de Implementación en 4 Pasos
Los arquitectos de sistemas y directores de tecnología que buscan reducir sus costos de infraestructura de IA deben seguir esta hoja de ruta de diversificación:
- Desacoplar la Capa de Inferencia del Proveedor de Nube Primario: Utilizar estándares abiertos de empaquetado de modelos (como vLLM, TGI o Triton Inference Server) sobre contenedores Docker para garantizar la portabilidad absoluta entre AWS, GCP y nubes especializadas de GPUs.
- Auditar Cargas de Trabajo y Separar Tráfico Spot de Tráfico Reservado: Clasificar las tareas de procesamiento: derivar los lotes de datos y fine-tuning hacia instancias spot de bajo costo, y contratar capacidad reservada a largo plazo únicamente para endpoints con requisitos estrictos de SLA.
- Implementar Mecanismos de Fallback y Balanceo Geográfico: Configurar proxies de enrutamiento de inferencia que distribuyan las solicitudes entre múltiples proveedores de cómputo GPU según la disponibilidad y el precio horario de cada región.
- Medir el Retorno de Inversión por Token Servido: Establecer dashboards de telemetría financiera en tiempo real que calculen el costo exacto por usuario activo y por flujo de trabajo agéntico, detectando anomalías presupuestarias antes de fin de mes.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor