Google DeepMind presenta modelo multimodal optimizado para búsqueda local y ejecución en silicio de borde
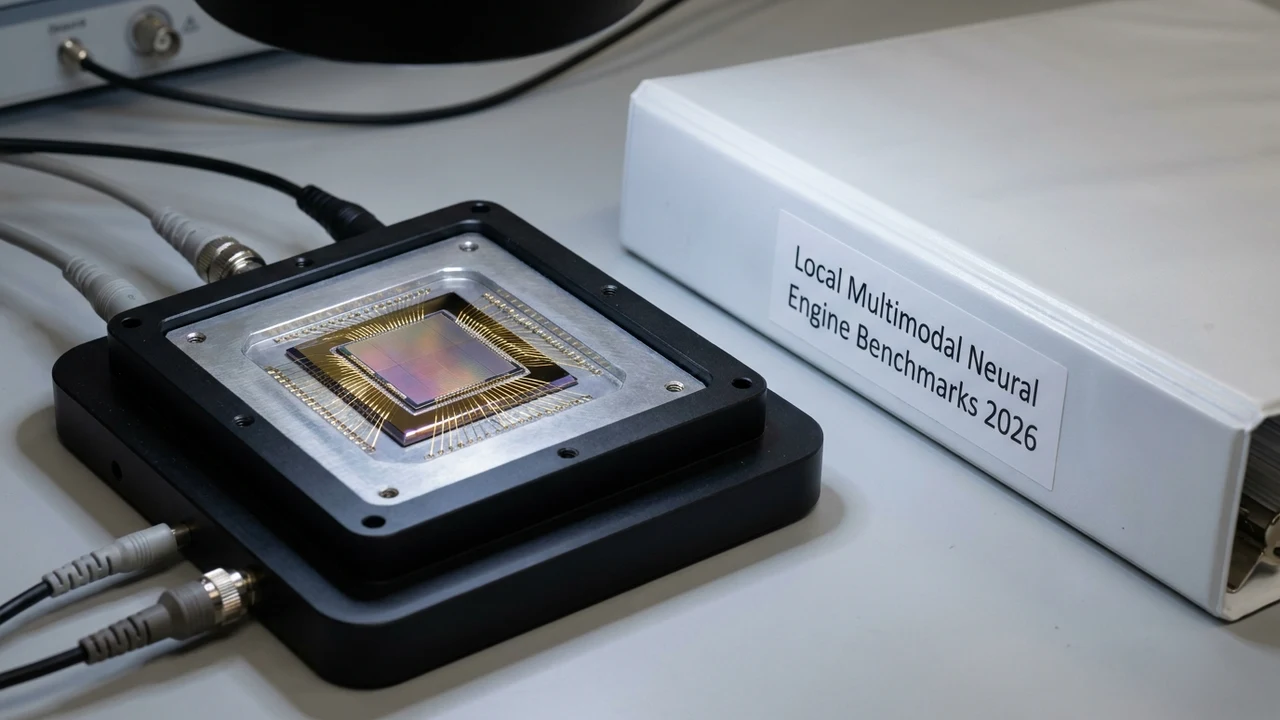
En un salto de ingeniería que redefine la frontera entre los centros de datos masivos y los dispositivos terminales, Google DeepMind ha presentado su nueva arquitectura multimodal ultracompacta diseñada específicamente para ejecución nativa en silicio de borde (edge NPUs). Documentado en los repositorios de Google DeepMind Research y detallado operativamente en el Android Developers Blog, el sistema comprime representaciones de texto, audio en tiempo real y visión computacional en menos de 2,4 gigabytes de memoria, facultando a teléfonos móviles, estaciones industriales y vehículos autónomos para indexar y buscar información local con latencias inferiores a 15 milisegundos y sin transmitir telemetría a servidores remotos.
1. Anatomía y Contexto: La Descentralización del Razonamiento Multimodal
El paradigma predominante de la inteligencia artificial durante el último lustro dependió casi exclusivamente de la nube centralizada. Cada consulta que involucraba el análisis de una imagen de alta resolución, la transcripción de una nota de voz o la búsqueda de documentos personales requería empaquetar los datos del usuario, transmitirlos a través de redes celulares y procesarlos en gigantescas granjas de servidores hiperescalares. Este enfoque presentaba tres barreras estructurales insalvables: dependencia permanente de conectividad de banda ancha, costos operativos recurrentes de inferencia en la nube y riesgos inherentes a la privacidad de datos confidenciales.
La nueva propuesta de DeepMind invierte radicalmente esta ecuación. Al combinar técnicas avanzadas de destilación de conocimiento cruzado (cross-modal knowledge distillation) con cuantización no uniforme de 2 y 4 bits calibrada directamente para las matrices de aceleración de las unidades de procesamiento neuronal (NPU), los investigadores lograron transferir las capacidades de razonamiento de un modelo de 70.000 millones de parámetros a una estructura de apenas 3.200 millones de parámetros que se ejecuta de manera continua consumiendo menos de 2,8 vatios de energía.
El avance fundamental radica en su motor de búsqueda semántica local continua. El modelo crea y actualiza un índice vectorial en memoria flash local sobre todos los archivos, capturas de pantalla, audios de reuniones y documentos almacenados en el dispositivo, permitiendo al usuario realizar consultas naturales cruzadas ("Encuentra el presupuesto de pintura que fotografié la semana pasada y compáralo con el audio del contratista") en cuestión de milisegundos y con el dispositivo en modo avión.
"Hemos demostrado que no es necesario pagar el peaje de la latencia de red ni sacrificar la privacidad de los datos personales para acceder a capacidades multimodales de primer nivel. El futuro de la informática cotidiana no reside en enviar nuestra vida digital a centros de datos lejanos, sino en dotar al silicio que llevamos en el bolsillo o en el tablero de trabajo de la capacidad de comprender su entorno inmediato de forma totalmente autónoma y privada."
2. Arquitectura Técnica Profunda: Cuantización Adaptativa y Motor de Grafos Vectoriales
El rendimiento del nuevo modelo se sustenta en tres innovaciones clave en la compilación y ejecución de redes neuronales profundas sobre hardware heterogéneo:
- Atención Dispersa Multimodal con Compartición de Memoria KV: A diferencia de los modelos tradicionales que mantienen cachés de claves y valores (KV Caches) separadas para imágenes y texto, la arquitectura unifica las representaciones espaciales y lingüísticas en un espacio latente común, reduciendo la huella de memoria RAM en un 65% durante conversaciones de contexto prolongado.
- Cuantización con Calibración de Rango Dinámico (Mixed-Precision INT2/INT4/FP8): Las capas de atención crítica que manejan razonamiento lógico retienen precisión en punto flotante de 8 bits (FP8), mientras que los pesos de extracción sensorial de bajo nivel se cuantizan a enteros de 2 bits mediante matrices optimizadas para la arquitectura Tensor G5 y procesadores Snapdragon X Elite.
- Base de Datos Vectorial Embebida de Grafo HNSW Cuantizado: El motor integra un subsistema de indexación vectorial embebido escrito en C++ que genera embeddings de 256 dimensiones directamente sobre el hardware criptográfico del dispositivo. El almacenamiento se cifra con claves derivadas del Trusted Platform Module (TPM) o Secure Enclave, garantizando que ninguna aplicación de terceros pueda volcar el grafo de conocimiento.
- Pipeline de Inferencia Asíncrono de Cero Copia (Zero-Copy Pipeline): Los fotogramas de la cámara y los búferes de audio del micrófono se transfieren directamente a la memoria de la NPU mediante DMA (Direct Memory Access), evitando copias intermedias en la memoria principal del sistema operativo y eliminando caídas de cuadros (jank).
3. Análisis Financiero y FinOps: El Colapso del Costo Marginal de Inferencia
Desde una perspectiva económica y de arquitectura en la nube, transferir el procesamiento hacia el hardware del cliente genera un impacto transformador en la estructura de costos corporativos:
- Reducción Drástica del OpEx en Servidores Hiperescala: En plataformas con millones de usuarios concurrentes, cada consulta multimodal procesada en la nube cuesta en promedio entre USD 0,004 y USD 0,012. Al delegar la búsqueda y el razonamiento al procesador del cliente, el costo marginal de inferencia para el proveedor se reduce literalmente a cero dólares.
- Impacto en CapEx y Renovación de Dispositivos: La demanda de estas capacidades impulsa el ciclo de actualización de hardware empresarial (laptops, terminales de mano y gateways industriales con NPUs integradas), amortizando la inversión a través de un mayor valor percibido por el usuario final y eliminando cuotas mensuales de suscripciones a APIs externas.
- Retorno de la Inversión (ROI) en Operaciones de Campo: Para industrias con flotas de técnicos en campo (minería, agricultura, petróleo), la capacidad de procesar manuales técnicos y diagnósticos visuales sin enlace satelital reduce los tiempos muertos de mantenimiento en un 28%, amortizando la renovación del parque informático en menos de 9 meses.
4. Implicancias y Oportunidades para Empresas y PyMEs de Argentina y América Latina
La democratización de modelos multimodales locales representa una ventaja competitiva de primer orden para las empresas de América Latina, una región caracterizada por brechas de infraestructura de conectividad:
- Operatividad Blindada en el Sector Agropecuario y Minero: En las zonas rurales de la pampa húmeda argentina, la Patagonia o la región andina, la falta de cobertura celular 4G/5G paraliza frecuentemente las aplicaciones basadas en la nube. Un modelo multimodal de borde permite a ingenieros agrónomos escanear cultivos con la cámara del celular, detectar plagas y recibir recomendaciones agronómicas complejas sin requerir conexión a Internet.
- Cumplimiento Riguroso de Normativas de Confidencialidad Médica: Hospitales y clínicas privadas de Argentina pueden desplegar estaciones de diagnóstico y transcripción de historias clínicas basadas en este modelo en PCs locales, garantizando el cumplimiento irrestricto de la Ley de Protección de Datos Personales al asegurar que los estudios y audios de los pacientes nunca salgan de la red física del sanatorio.
- Desarrollo de Soluciones de Retail y Punto de Venta Inteligente (POS): Pequeños comercios y supermercados regionales pueden incorporar reconocimiento visual de productos a granel en balanzas y terminales POS de bajo costo sin abonar costosos servicios de nube en dólares, blindando su rentabilidad frente a fluctuaciones cambiarias.
5. Hoja de Ruta Técnica: Checklist de Implementación en 4 Pasos
Los equipos de desarrollo de software e ingeniería de sistemas deben trazar una estrategia de adopción de IA de borde mediante las siguientes acciones:
- Evaluar la Compatibilidad del Parque de Dispositivos: Realizar un inventario de hardware corporativo verificando la presencia de procesadores con soporte para instrucciones de aceleración neuronal (Qualcomm NPU, Apple Neural Engine, Intel Core Ultra o AMD Ryzen AI).
- Adoptar Runtimes de Inferencia de Borde Estandarizados: Configurar proyectos móviles y de escritorio utilizando runtimes como LiteRT (anteriormente TensorFlow Lite), ONNX Runtime Mobile o ExecuTorch, evaluando la conversión de modelos hacia formatos cuantizados INT4.
- Implementar Arquitecturas Híbridas de Búsqueda Local-Nube (Tiered Fallback): Diseñar la experiencia de usuario para que las consultas cotidianas se resuelvan al 100% en el dispositivo, reservando las llamadas a APIs remotas exclusivamente para tareas que requieran acceso a bases de conocimiento externas actualizadas.
- Auditar los Mecanismos de Aislamiento de Memoria: Asegurar que los índices vectoriales y la memoria temporal del modelo local estén protegidos por cifrado a nivel de sistema de archivos (FBE) y permisos estrictos de espacio de usuario (sandboxing de aplicaciones).
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor