CoreWeave activa clústeres multirack NVIDIA Vera Rubin NVL72 orquestados nativamente en Kubernetes
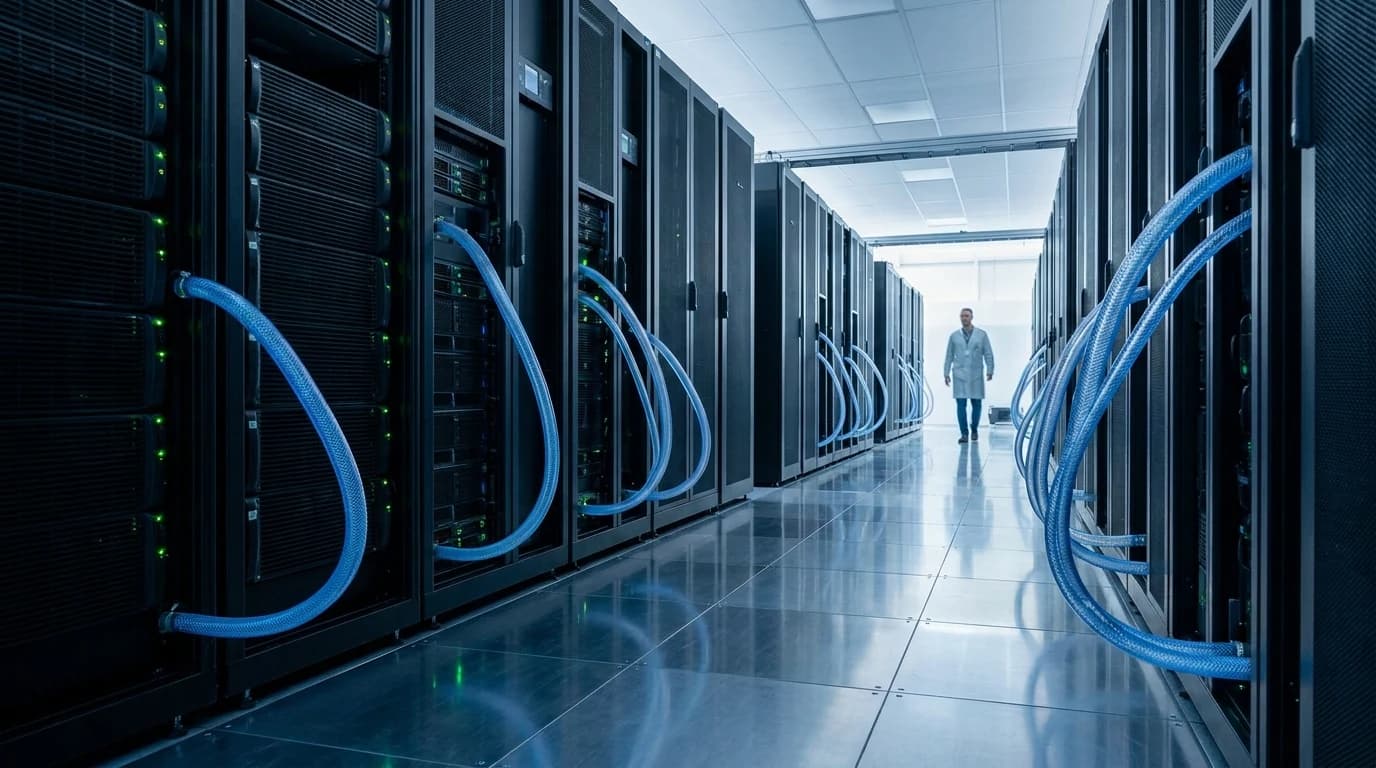
Capacidad de Cómputo Unificado de Frontera:
La interconexión NVL72 permite que 72 GPUs operen como un único acelerador gigantesco gracias a un plano de conmutación NVLink de 130 Terabytes por segundo de ancho de banda bidireccional, reduciendo los tiempos de entrenamiento de modelos fundacionales hasta en un 60%.
La especialización de la nube de cómputo para inteligencia artificial ha alcanzado un nuevo estándar de rendimiento industrial. Este 16 de septiembre de 2026, el operador especializado CoreWeave anunció la puesta en servicio comercial de sus nuevos clústeres multirack basados en la arquitectura NVIDIA Vera Rubin NVL72, gestionados de forma completamente nativa mediante operadores de orquestación en Kubernetes.
Este despliegue marca un punto de inflexión en la ingeniería de plataformas de nube. Mientras que los proveedores de nube tradicionales tardan meses en adaptar sus capas de virtualización hipervisada, CoreWeave ha implementado un entorno de ejecución bare-metal con aceleración por hardware donde los desarrolladores pueden reservar clústeres masivos a través de manifiestos estándar de Kubernetes (CRDs), eliminando por completo la sobrecarga (overhead) de capas intermedias de virtualización.
"Gestionar 72 procesadores gráficos masivos y sus switches de red como un solo dominio coherente de memoria compartida dentro de Kubernetes redefine la agilidad de los equipos de IA. Los investigadores ya no deben lidiar con configuraciones manuales de red de bajo nivel; simplemente declaran sus pods y el clúster se encarga del paralelismo en tiempo real." — Equipo de Arquitectura de Sistemas de CoreWeave.
Innovación Técnica: Interconexión NVLink Switch y Dominio de Memoria Coherente
La principal barrera técnica en el entrenamiento e inferencia de modelos que superan el billón de parámetros radica en el cuello de botella de comunicación entre nodos (inter-node latency). En configuraciones tradicionales de servidores interconectados por interfaces PCIe o redes Ethernet estándar, la sincronización de pesos y gradientes ralentiza el cálculo intensivo.
La solución NVL72 solventa este obstáculo a nivel físico:
- Backplane de Cobre Pasivo NVLink: El rack físico integra una red troncal de cobre que conecta las 72 GPUs directamente a bandejas de switches NVLink sin necesidad de transceptores ópticos adicionales en el rack, disminuyendo el consumo de energía en 20 kW por armario.
- Espacio de Direccionamiento de Memoria Compartida: Las GPUs acceden a un grupo unificado de memoria de alta velocidad (HBM) de múltiples terabytes mediante primitivas directas de lectura/escritura en hardware, alcanzando latencias de transferencia inferiores a 50 nanosegundos.
- Operador de Red de Kubernetes de Nivel de Núcleo (K8s CNI): CoreWeave diseñó un controlador de red que expone la topología de la tela NVLink al programador de pods de Kubernetes, asegurando que los procesos con alto intercambio de datos se ubiquen siempre en GPUs adyacentes.
Análisis Financiero y FinOps: Costo por TFLOP vs. Eficiencia por Época
Aunque la tarifa horaria de alquiler de un rack completo NVL72 representa una cifra considerable en los libros contables corporativos, el análisis de costo por tarea terminada (Cost-per-Workload) invierte la ecuación económica. Debido a que el ancho de banda masivo elimina los tiempos muertos de espera en las GPUs:
- Reducción de hasta un 45% en el costo total por ciclo de entrenamiento (CapEx/OpEx): Al completar las épocas en la mitad del tiempo de reloj, se reduce el número de horas totales facturadas.
- Ahorro Energético PUE: El diseño de refrigeración líquida integral reduce el costo de enfriamiento eléctrico en un 35% respecto a centros de datos refrigerados por aire convencionales.
Implicancias para la Industria del Software en América Latina
El acceso a este nivel de potencia a través de Kubernetes bajo demanda cambia radicalmente las posibilidades para la industria tecnológica de la región:
- Entrenamiento de Modelos Regionales Especializados: Equipos de investigación y startups de Argentina pueden afinar modelos fundacionales en español rioplatense o adaptados a regulaciones contables y tributarias locales en cuestión de días y sin necesidad de comprar equipamiento físico.
- Desarrollo de Software Nativo de Cloud Habilitado para IA: La estandarización en Kubernetes permite que ingenieros de software locales desplieguen cargas de trabajo en clústeres remotos de alta performance utilizando las mismas herramientas que ya dominan (Helm, ArgoCD y Terraform).
- Exportación de Servicios de Ingeniería de Datos: Las empresas argentinas de software pueden posicionarse como integradoras y operadoras de infraestructura compleja de IA para clientes corporativos de Estados Unidos y Europa.
Checklist Técnico: 5 Pasos para Preparar Cargas de IA en Kubernetes Bare-Metal
- Paso 1: Instalación del NVIDIA GPU Operator: Desplegar el operador oficial de GPU en el clúster de Kubernetes para automatizar la carga de controladores de kernel, utilidades de diagnóstico CUDA y el complemento de dispositivo de contenedor.
- Paso 2: Habilitación de Topología NUMA y CPU Pinning: Configurar el Topology Manager de Kubernetes con la política
single-numa-nodepara garantizar que los contenedores de GPU compartan el mismo canal de memoria que las CPUs asignadas. - Paso 3: Configuración de Métricas DCGM en Prometheus: Implementar el exportador de métricas de administración del centro de datos de GPU (DCGM) para capturar en tiempo real la temperatura de memoria HBM, la potencia consumida y el estrangulamiento térmico (throttling).
- Paso 4: Implementación de Chequeos de Salud Previos al Trabajo (Pre-Job Validation): Ejecutar pods de prueba efímeros que corran pruebas de ancho de banda punto a punto (NCCL AllReduce test) antes de iniciar un trabajo de entrenamiento prolongado para descartar enlaces degradados.
- Paso 5: Respaldo y Checkpointing Asíncrono en S3/Blob Storage: Configurar los marcos de entrenamiento (PyTorch/DeepSpeed) para volcar puntos de control de memoria (checkpoints) cada 30 minutos a matrices de almacenamiento de alta velocidad con escritura multi-hilo para evitar pérdida de progreso ante fallos de hardware.
Fuentes & Referencias Verificadas
Modernizá tu Infraestructura y Software con Siglo 21 Soluciones
Transformamos la tecnología de tu empresa con arquitecturas web de alto rendimiento, optimización FinOps y automatizaciones comerciales a medida. Contactanos hoy.
Contactar a un Consultor