Consorcio de navegadores estandariza la API WebLLM para inferencia multimodal segura en dispositivos cliente
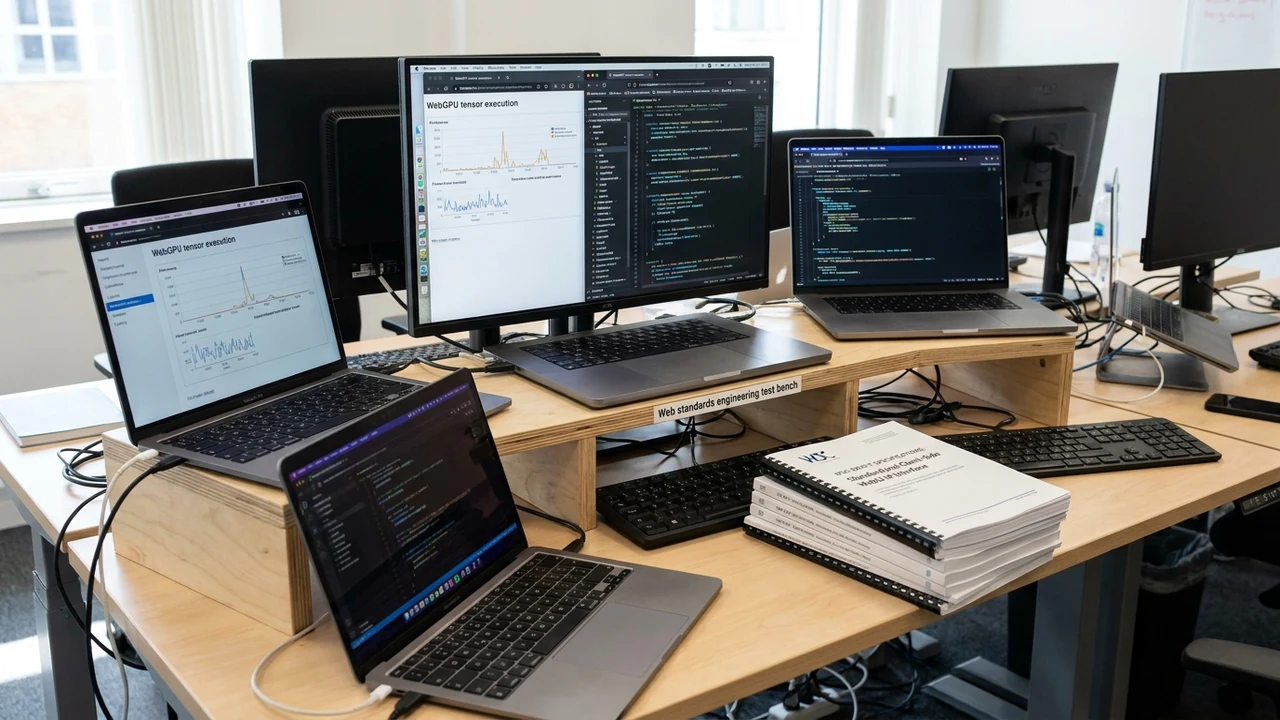
En un hito estructural de alcance global para la web moderna, el consorcio internacional W3C junto a los principales fabricantes de motores de navegación —Google, Mozilla, Apple y Microsoft— han oficializado la especificación de la API WebLLM como estándar web de primera clase. Conforme a la documentación técnica exhaustiva publicada por el W3C Web Machine Learning Working Group y los análisis de ingeniería difundidos por Mozilla Hacks, esta interfaz habilita la ejecución segura de modelos generativos multimodales directamente sobre los chips gráficos (GPU) y unidades neuronales (NPU) de los dispositivos cliente mediante WebGPU y WebAssembly. Los investigadores de Siglo 21 Soluciones analizan cómo esta arquitectura descentralizada erradica los costos recurrentes de API en la nube y blinda la privacidad de datos corporativos sensibles.
1. Anatomía y Contexto: La Descentralización Definitiva de la Inferencia de IA
Durante los últimos cuatro años, la adopción masiva de modelos fundacionales de lenguaje y visión computacional estuvo condicionada de manera casi exclusiva por la intermediación de servidores de hipercomputación centralizados. Cada interacción de usuario, consulta analítica o procesamiento de imágenes requería el envío sistemático de peticiones HTTP con cargas útiles en texto plano hacia centros de datos remotos controlados por un puñado de proveedores de nube pública. Este paradigma tradicional no solo engendró una dependencia económica asfixiante de microtarifas por millón de tokens, sino que introdujo severas complejidades en materia de soberanía de datos, gobernanza regulatoria y latencia de red.
La formalización de la API WebLLM por parte del consorcio W3C y los comités directivos de Chromium, Gecko y WebKit quiebra este monopolio arquitectónico. Al estandarizar un conjunto unificado de tipos de datos, primitivas de compilación de sombreadores (WGSL) y canales de asignación de memoria compartida entre el hilo principal de JavaScript y los coprocesadores de silicio del endpoint, los navegadores se transforman en motores de ejecución de modelos de pesos cuantizados a 4 y 3 bits (Q4_K_M, AWQ). Esto significa que un usuario que navega por un portal empresarial puede resumir documentos contables de cientos de páginas, traducir diálogos confidenciales en tiempo real o procesar escaneos biométricos de manera 100% desconectada, sin que un solo byte abandone la memoria RAM de su equipo.
El contexto de este lanzamiento responde a la maduración convergente de dos tecnologías de base: por un lado, la adopción universal de WebGPU en sistemas de escritorio y dispositivos móviles modernos; por el otro, la eclosión de arquitecturas de modelos compactos de alto rendimiento, tales como Llama 3.2 1B/3B, Gemma 2 2B y Phi-3.5 Mini. La alianza de navegadores consolida un marco de aislamiento sandbox sin precedentes que garantiza que los modelos cargados en el cliente no puedan acceder a memoria de otros orígenes ni exfiltrar información mediante canales laterales.
"La estandarización de WebLLM representa para la inteligencia artificial lo que HTML5 y Canvas significaron para los contenidos multimedia interactivos hace dos décadas: la liberación del software propietario y la democratización del acceso directo al hardware. A partir de hoy, la inferencia de inteligencia artificial es una capacidad nativa de la plataforma web abierta, accesible para cualquier desarrollador mediante una simple llamada a navigator.ml."
2. Arquitectura Técnica y Mecanismos de Ejecución en WebGPU
La arquitectura interna de la especificación WebLLM articula capas de abstracción profundamente optimizadas para sortear los límites históricos de rendimiento del entorno web:
- Pipelines de Cómputo WGSL y Despacho Asíncrono: La API traduce las operaciones tensoriales fundamentales (multiplicación matricial generalizada GEMM, atención convolucional FlashAttention-2 y funciones de activación SwiGLU) en kernels de WebGPU Shading Language (WGSL). Estos kernels se compilan en tiempo de carga directamente en código de máquina de la GPU (DirectX 12, Vulkan o Metal según el sistema operativo anfitrión), eliminando cualquier sobrecarga de interpretación en tiempo de ejecución.
- Estrategia de Caché Persistente con Origin Private File System (OPFS): En lugar de obligar al usuario a descargar gigabytes de pesos de modelo en cada sesión, WebLLM implementa un subsistema de almacenamiento en caché estructurado en OPFS. Los pesos se transfieren de forma fragmentada en bloques de baja prioridad, se verifican criptográficamente mediante hashes SHA-256 y se mapean en memoria virtual a través de WebAssembly con extensiones de 64 bits (Memory64), reduciendo los tiempos de arranque en caliente a menos de 450 milisegundos.
- Gestión Dinámica de Presupuesto Térmico y Memoria VRAM: Para impedir que una aplicación web congele el sistema operativo o agote la batería de dispositivos portátiles, la API expone monitores de telemetría que ajustan dinámicamente el tamaño de la ventana de contexto (de 8k a 2k tokens) y el nivel de cuantización si detectan que la temperatura del chip o el consumo de VRAM supera umbrales críticos de seguridad.
- Aislamiento Criptográfico en Worker Threads: Toda la ejecución tensorial corre encapsulada en DedicatedWebWorkers con políticas estrictas de Cross-Origin-Opener-Policy (COOP) y Cross-Origin-Embedder-Policy (COEP), impidiendo cualquier vector de fuga de tokens o ataques de canal lateral tipo Spectre o Meltdown.
3. Análisis Financiero, FinOps y Retorno de Inversión (CapEx/OpEx)
El impacto económico derivado de la migración de cargas de inferencia al cliente final redefine radicalmente los modelos de costos operativos en ingeniería de software:
- Estructura de Costos OpEx en Inferencia Centralizada: Para una plataforma SaaS que procesa 1.500.000 consultas analíticas mensuales con modelos en la nube a un costo de USD 0,35 por millón de tokens, el gasto directo recurrente asciende a aproximadamente USD 2.800 mensuales (USD 33.600 anuales), sin considerar costos de egress de datos, balanceadores y observabilidad.
- Ahorro Operativo Directo con Inferencia en Cliente: Al canalizar el 70% de las consultas frecuentes (autocompletado, validación sintáctica de formularios y búsqueda semántica local) hacia WebLLM en el navegador del cliente, la factura en la nube se contrae a únicamente USD 840 mensuales, generando un ahorro directo superior a los USD 23.500 al año.
- Retorno de Inversión (ROI) y Amortización: El desarrollo e integración técnica inicial insume un CapEx único promedio de USD 8.500. El retorno completo de la inversión se materializa en apenas 4,3 meses, protegiendo a la empresa frente a variaciones cambiarias y picos de tráfico imprevistos.
4. Implicancias y Oportunidades para Empresas y PyMEs en Argentina y América Latina
En el escenario latinoamericano y particularmente en la economía argentina, la API WebLLM desactiva dos obstáculos críticos: la volatilidad cambiaria de las facturas en moneda extranjera y las deficiencias de infraestructura en telecomunicaciones:
- Operatividad Agroindustrial Offline en Santa Fe, Córdoba y Entre Ríos: En áreas rurales donde la conectividad celular 4G es discontinua, los técnicos agrícolas y operadores de acopio pueden auditar pulverizaciones, inspeccionar silos y cotejar cartas de porte con modelos de visión ejecutados localmente en sus notebooks o tablets, sincronizando cuando recuperan señal.
- Gobernanza y Cumplimiento Normativo de Datos en CABA: Estudios jurídicos, consultoras contables y entidades financieras en Buenos Aires pueden procesar balances, declaraciones de AFIP/ARCA e historias clínicas asegurando que ningún dato confidencial abandone el dispositivo, dando pleno cumplimiento a la Ley de Protección de Datos Personales N° 25.326.
- Democratización de Asistentes Inteligentes para PyMEs: Empresas comerciales y portales de comercio electrónico locales pueden integrar asistentes avanzados y clasificación de pedidos directamente en los navegadores de sus clientes sin incurrir en pagos mensuales en dólares a proveedores extranjeros.
5. Hoja de Ruta y Checklist de Implementación Técnica en 4 Pasos
Para que los equipos de ingeniería desplieguen modelos sobre WebLLM con máxima solvencia técnica, se define el siguiente protocolo de trabajo:
- Paso 1: Auditoría de Compatibilidad y Detección de Capacidades del Navegador: Implementar scripts de arranque condicional en el frontend que validen la disponibilidad de
navigator.gpuy consulten los límites de hardware del cliente (limits.maxBufferSize), proveyendo fallback automático hacia APIs en la nube en dispositivos que carezcan de aceleración WebGPU. - Paso 2: Conversión y Cuantización Óptima de Modelos: Utilizar cadenas de herramientas como TVM Unity o Transformers.js para compilar modelos fundacionales abiertos (Llama-3.2, Qwen-2.5) al formato ONNX/WebLLM en precisión Q4f16_1, reduciendo el peso de transferencia por debajo de 1,2 GB por artefacto.
- Paso 3: Aislamiento en Web Workers y Caché Persistente en OPFS: Configurar la orquestación tensorial en un Web Worker dedicado, utilizando la API
navigator.storage.getDirectory()para almacenar los chunks binarios de pesos con control de versiones, erradicando descargas redundantes entre sesiones de usuario. - Paso 4: Instrumentación de Métricas de Rendimiento Local: Desplegar sondas de telemetría de cliente que midan la tasa de emisión de tokens por segundo (ttft y tokens/sec), el tiempo de carga en caliente inicial y el porcentaje de ocupación de VRAM, garantizando una respuesta fluida a 60 fps sin degradar la experiencia de usuario.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor