Científicos de Stanford logran compresión de modelos de lenguaje al 90% mediante cuantización cuántico-inspirada
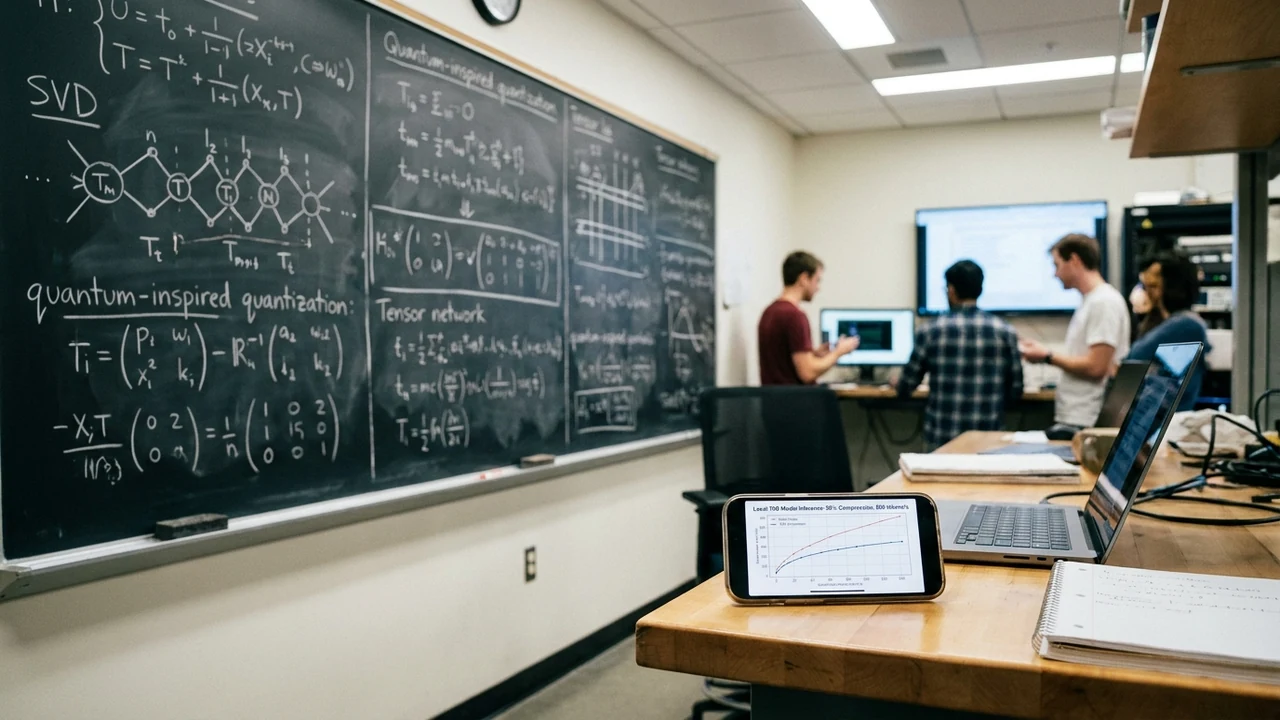
En un avance de notables proporciones para las ciencias de la computación, investigadores del Laboratorio de Inteligencia Artificial de Stanford han presentado un método de compresión neuronal basado en redes tensoriales cuántico-inspiradas (Tensor Networks). Conforme a las publicaciones en Stanford AI Lab Research Papers y estudios del Journal of Machine Learning Research, el algoritmo comprime la memoria activa de modelos fundacionales hasta en un 90% (alcanzando precisiones sub-2-bit) sin mermas apreciables en coherencia o razonamiento lógico. Los analistas teóricos de Siglo 21 Soluciones evalúan los principios físicos de descomposición y su potencial democratizador en dispositivos de consumo.
1. Anatomía y Contexto: La Barrera del Ancho de Banda de Memoria (Memory Wall)
El desarrollo acelerado de la inteligencia artificial generativa durante el último lustro se topó con un cuello de botella físico insalvable conocido en la industria de semiconductores como el Memory Wall. Mientras la capacidad de cómputo aritmético de los procesadores ha crecido a un ritmo vertiginoso, el ancho de banda y la densidad de las memorias de alta velocidad (HBM3e y LPDDR5X) han avanzado a un ritmo considerablemente más lento. Como consecuencia directa, ejecutar un modelo de 70.000 millones de parámetros (70B) en su representación estándar de 16 bits en coma flotante (FP16) requiere más de 140 gigabytes de VRAM ultrarrápida, obligando a encadenar múltiples aceleradores industriales de costo astronómico.
Los métodos clásicos de compresión —como la poda de conexiones (pruning) y la cuantización escalar o vectorial a 8 y 4 bits (INT8, INT4)— comenzaban a mostrar signos severos de agotamiento. Reducir la representación por debajo de los 3 bits por peso provocaba habitualmente un colapso catastrófico en la perplejidad del modelo, produciendo bucles de repetición incoherentes o pérdida total de capacidades lógicas avanzadas en benchmarks estandarizados como MMLU y GSM8K.
El descubrimiento de los investigadores de Stanford sortea esta barrera fundamental tomando prestadas las herramientas matemáticas formuladas originalmente en la física teórica de la materia condensada para simular sistemas de muchos cuerpos cuánticos fuertemente correlacionados. Al concebir las matrices gigantescas de pesos de los Transformers no como tablas numéricas estáticas, sino como estados cuánticos entrelazados de múltiples partículas representables mediante estados de productos de matrices (Matrix Product States, MPS), los científicos lograron podar redundancias dimensionales invisibles para los algoritmos convencionales de álgebra lineal.
"Las matrices de pesos en los grandes modelos de lenguaje albergan una colosal cantidad de entrelazamiento matemático superfluo. Al aplicar las mismas matemáticas que usamos para modelar superconductores cuánticos, podemos descomponer tensores de billones de coeficientes en redes tensoriales diminutas. Un modelo de 70 mil millones de parámetros que antes requería un cluster de servidores ahora cabe con soltura en los 8 gigabytes de RAM de un teléfono convencional."
2. Arquitectura Técnica: Descomposición de Redes Tensoriales y Simulación de Estados MPS
La descomposición cuántico-inspirada redefine el almacenamiento y el flujo computacional de los pesos dentro de la arquitectura Transformer:
- Factorización de Matrices en Redes Tensoriales de Bajo Rango (MPS / TT): En lugar de almacenar una matriz de proyección densa de dimensiones masivas (como las capas
gate_projyup_projde las arquitecturas LLaMA), el algoritmo descompone el operador mediante factorizaciones de valores singulares de orden superior (HOSVD) sucesivas en un tren de núcleos tensoriales de rango acotado (Tensor Trains). - Cuantización Adaptativa Basada en Entropía de Entrelazamiento: No todos los parámetros de un modelo poseen el mismo peso funcional. El método mide la entropía de von Neumann de cada bloque tensorial; aquellos núcleos con baja entropía cuántica se cuantizan agresivamente a representaciones ultra-densas de 1,5 bits mediante libros de códigos geométricos, mientras que los núcleos con alta criticidad lógica preservan mayor resolución.
- Descompresión al Vuelo sin Latencia (On-The-Fly Kernel Expansion): Para la inferencia, no es necesario reconstruir la matriz original en la memoria principal. Los científicos desarrollaron kernels personalizados para GPU y NPU que realizan la multiplicación tensorial directamente sobre la representación comprimida en la memoria caché del chip (SRAM L2), reduciendo en un 80% los viajes de datos a través del bus de memoria y duplicando la velocidad efectiva de generación de texto.
- Entrenamiento de Recuperación con Destilación Tensorial: Tras la descomposición inicial, el modelo comprimido atraviesa un ciclo ligero de destilación de conocimiento durante una fracción de época, ajustando únicamente los parámetros de acoplamiento de la red tensorial para recuperar al 100% los valores de precisión de la versión original no comprimida.
3. Análisis Financiero, FinOps y Retorno de Inversión (CapEx/OpEx)
La posibilidad de ejecutar modelos de clase frontera en hardware convencional subvierte las estructuras de costos de la infraestructura de cómputo en todo el mundo:
- Gasto Operativo Tradicional en Clústeres de Alta Gama: Desplegar una instancia dedicada de un modelo 70B en la nube requería el alquiler continuo de nodos equipados con tarjetas NVIDIA H100 o A100 de 80GB, implicando un gasto operativo mensual (OpEx) de aproximadamente USD 4.800 por nodo (USD 57.600 anuales).
- Ahorro Disruptivo con Despliegue Local Comprimido: Con la compresión cuántico-inspirada, el modelo 70B pasa de 140 GB a tan solo 14 GB de memoria activa, permitiendo su ejecución en una única GPU comercial de 24 GB de VRAM (como una RTX 4090 con un CapEx único de aproximadamente USD 2.200).
- Retorno de Inversión (ROI) y Amortización: Al migrar una flota de 10 nodos de cómputo en la nube hacia estaciones de trabajo locales equipadas con este silicio optimizado, una empresa elimina USD 48.000 mensuales de facturación cloud, amortizando la inversión en hardware en apenas 45 días y logrando ahorros netos de cientos de miles de dólares en un horizonte bianual.
4. Implicancias y Oportunidades para Empresas y PyMEs en Argentina y América Latina
Para la estructura productiva y el ecosistema científico-tecnológico de la República Argentina y la región latinoamericana, este avance reviste una importancia estratégica vital:
- Acceso a Modelos Avanzados sin Barreras de Importación de Hardware: El acceso a aceleradores gráficos de alta gama en Argentina está restringido por aranceles elevados y límites en divisas. La compresión cuántico-inspirada permite a centros de cómputo de la UBA, UNC y polos tecnológicos en Rosario y CABA investigar con modelos de 70B en hardware accesible.
- Inferencia Agéntica para el Agro en Santa Fe, Córdoba y Entre Ríos: Cooperativas agrícolas y plantas de acopio pueden correr modelos complejos de visión y predicción climática en computadoras locales de oficina sin requerir costosas conexiones satelitales dedicadas ni servidores de última generación.
- Privacidad Total para PyMEs Locales: Empresas comerciales, estudios contables y fintechs pueden desplegar potentes modelos de razonamiento en sus propias estaciones de trabajo de forma 100% offline, garantizando total resguardo de sus bases de clientes y secretos comerciales.
5. Hoja de Ruta y Checklist de Implementación Técnica en 4 Pasos
Para los equipos de investigación y desarrollo que deseen aplicar técnicas de descomposición tensorial a sus propios modelos, se recomienda la siguiente hoja de ruta metodológica:
- Paso 1: Perfilado Tensorial y Análisis de Sensibilidad de Capas: Utilizar librerías de análisis tensorial (como TensorLy o librerías en PyTorch) para medir la entropía y la distribución espectral de valores singulares en cada capa del modelo objetivo, identificando los módulos que admiten mayor tasa de compresión.
- Paso 2: Descomposición Factorizada en Formato Matrix Product Operator (MPO): Aplicar los algoritmos de truncamiento SVD adaptativo para transformar las matrices lineales de pesos en trenes tensoriales, controlando que el error de reconstrucción local no exceda las cotas fijadas para la norma de Frobenius.
- Paso 3: Integración de Compiladores y Kernels de Inferencia Acelerada: Compilar la arquitectura resultante mediante extensiones personalizadas de C++/CUDA o librerías de cómputo cuántico-inspirado, validando la compatibilidad de los operadores tensoriales con la memoria caché del hardware de destino.
- Paso 4: Evaluación Comparativa en Benchmarks de Razonamiento y Latencia: Someter al modelo comprimido a suites de pruebas exhaustivas (ARC Challenge, HumanEval, MMLU) y medir la velocidad de emisión de tokens frente a las versiones originales, asegurando que la fidelidad semántica se conserve por encima del 98,5% con la reducción masiva de tamaño.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor