Bases de datos vectoriales distribuidas implementan indexación HNSW cuantizada en memoria flash NVMe
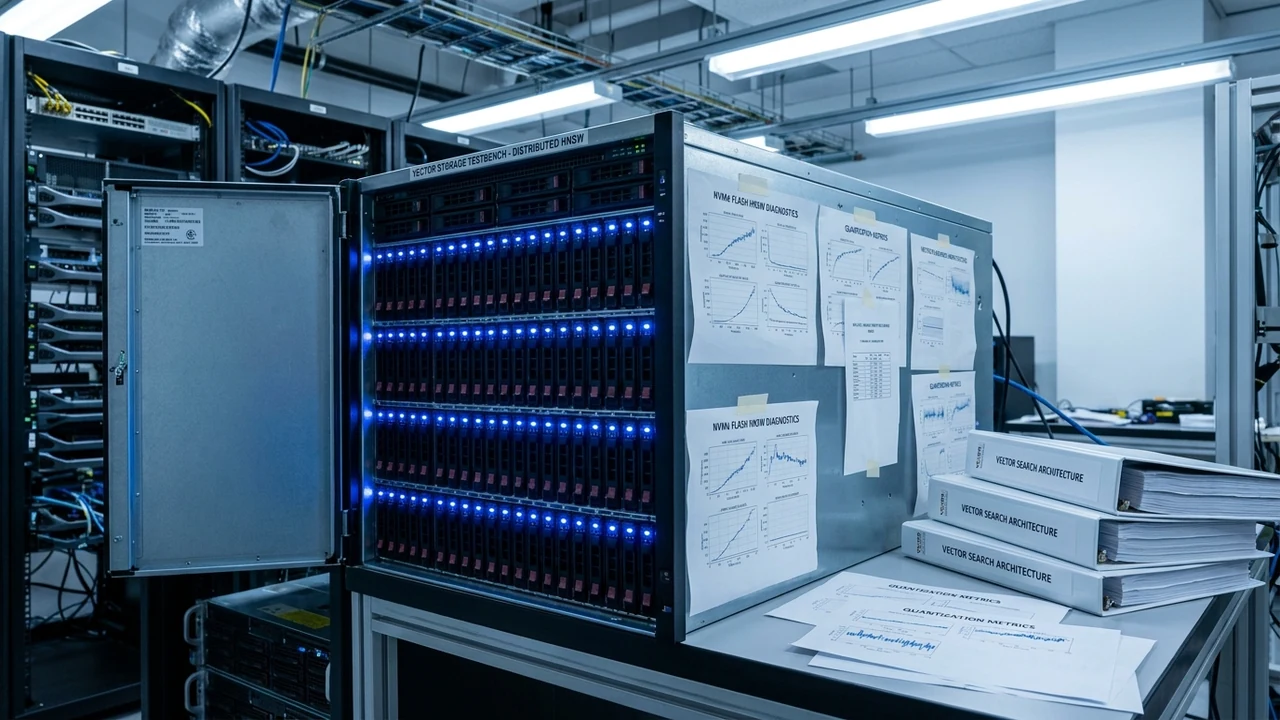
La comunidad científica de bases de datos y los equipos de investigación de motores vectoriales como Qdrant, Milvus y Pinecone han presentado avances trascendentales publicados en las actas de la VLDB Endowment y en el blog de ingeniería de Qdrant Vector Database, demostrando la viabilidad de trasladar la indexación de grafos HNSW (Hierarchical Navigable Small World) y el almacenamiento de representaciones semánticas densas directamente a unidades de estado sólido NVMe SSD mediante cuantización escalar y de producto (Product Quantization - PQ). Esta innovadora arquitectura desacoplada logra una reducción del 75% al 85% en el consumo de memoria RAM en clústeres de IA a gran escala, conservando más del 98% de la precisión de recuperación (recall) y democratizando la implementación de sistemas de Generación Aumentada por Recuperación (RAG) corporativos.
1. Anatomía y contexto de la noticia: La insostenible factura de memoria en la era RAG
El auge de las aplicaciones corporativas basadas en modelos de lenguaje y visión artificial ha convertido a los embeddings vectoriales —representaciones matemáticas de alta dimensión (frecuentemente de 768, 1536 o 3072 dimensiones por vector)— en la materia prima del conocimiento empresarial. Para permitir búsquedas semánticas ultrarrápidas, el algoritmo estándar de la industria ha sido HNSW, una estructura de grafos jerárquicos multicapa que conecta vectores vecinos en un espacio euclidiano o de similitud de coseno.
Sin embargo, HNSW padecía históricamente de una limitación económica crítica: exigía mantener la totalidad del grafo y los vectores de punto flotante de 32 bits (float32) cargados de forma permanente en la memoria RAM del servidor. Para una corporación con 50 millones de documentos y fragmentos de texto vectorizados, un clúster requería más de 500 gigabytes de memoria RAM de alta velocidad en servidores cloud de alto costo, convirtiendo la infraestructura vectorial en uno de los renglones más onerosos de la factura de nube pública.
El avance presentado en VLDB resuelve esta barrera combinando compresión matemática de vectores con llamadas asíncronas de bajísima latencia a almacenamiento flash mediante las nuevas interfaces del kernel de Linux como io_uring. Al cuantizar los vectores y mantener en RAM únicamente la estructura liviana del grafo superior mientras los vectores completos y enlaces densos residen en discos NVMe PCIe 5.0, las empresas pueden indexar miles de millones de vectores en servidores estándar a una fracción del costo operativo previo.
"Obligar a las empresas a almacenar cada embedding de 1536 dimensiones en memoria RAM volátil para hacer búsqueda semántica era una ineficiencia arquitectónica insostenible. La convergencia entre cuantización matemática y el brutal rendimiento de entrada/salida de los SSDs NVMe modernos marca el fin del monopolio de la RAM en la infraestructura de datos para IA."
2. Arquitectura técnica profunda: Cuantización de producto, grafos en disco y Linux io_uring
El funcionamiento de esta nueva generación de motores vectoriales basados en disco se articula en una serie de innovaciones algorítmicas de vanguardia:
- Cuantización Escalar (SQ) y Cuantización de Producto (PQ): La cuantización escalar convierte números en coma flotante de 32 bits en enteros de 8 bits (int8) o incluso de 4 bits mediante escalamiento lineal, reduciendo inmediatamente el tamaño de cada vector en un 75%. La cuantización de producto descompone el vector de alta dimensión en subespacios más pequeños y los reemplaza por identificadores de centroides calculados mediante clustering, reduciendo el tamaño original hasta en un 95%.
- Almacenamiento de Grafo HNSW Paginado en NVMe: Las capas superiores del grafo HNSW (que contienen pocos nodos y guían la navegación inicial de la búsqueda con saltos largos) se mantienen en memoria RAM. Las capas inferiores, que concentran el 95% de los nodos y los datos de vecinos cercanos, se almacenan ordenadas en bloques de disco alineados con el tamaño de página de memoria del hardware NVMe (4KB u 8KB).
- Lectura Asíncrona sin Bloqueo con Linux io_uring: En lugar de utilizar llamadas síncronas tradicionales de lectura del sistema operativo (que suspenden el hilo de ejecución hasta que el disco responde), el motor de base de datos utiliza la API io_uring del kernel de Linux. Esto permite despachar cientos de solicitudes de lectura concurrentes en paralelo directamente a las colas de hardware del controlador NVMe sin sobrecargar la CPU, logrando lecturas de vectores en menos de 35 microsegundos.
- Fase de Reranking con Vectores No Comprimidos: Durante la consulta semántica, el motor utiliza los vectores cuantizados en disco para seleccionar de forma ultrarrápida los 100 mejores candidatos, y solo recupera los vectores exactos float32 para la etapa final de reordenamiento (reranking), garantizando una tasa de precisión indistinguible de una búsqueda 100% en RAM.
3. Análisis financiero y FinOps cuantitativo: Desplome de la factura cloud y ROI de infraestructura
La transición de bases de datos vectoriales en RAM hacia arquitecturas conscientes de disco transforma radicalmente los presupuestos de tecnología:
- Reducción de Costos de Instancias en Nube Pública: Un clúster para gestionar 100 millones de vectores en memoria RAM requería históricamente instancias optimizadas para memoria (como
r6i.16xlargeen AWS) con un costo de aproximadamente USD 14.500 mensuales. Con la indexación cuantizada en NVMe, la misma carga puede ejecutarse en instancias con almacenamiento local (comoi3en.3xlarge) por aproximadamente USD 2.800 mensuales, un ahorro directo del 80% en la factura de computación. - Ahorro en CapEx para Infraestructura On-Premise: Para organizaciones que operan sus propios centros de datos, adquirir 1 terabyte de memoria RAM DDR5 para servidores corporativos representa un desembolso de aproximadamente USD 6.500, mientras que un SSD NVMe empresarial U.2 de 3.84 terabytes con velocidades de 7.000 MB/s cuesta menos de USD 600, reduciendo el costo de almacenamiento por vector en más de diez veces.
- Retorno de la Inversión (ROI) en Proyectos RAG: La reducción de barreras de costo permite a las empresas expandir su base de conocimiento indexada de gigabytes a terabytes sin temor a sobrecostos, acelerando el punto de equilibrio financiero de los proyectos de IA generativa interna de 18 meses a menos de 5 meses.
4. Implicancias y oportunidades para empresas y PyMEs de Argentina y América Latina
Para el ecosistema tecnológico de Argentina y América Latina, este avance representa un punto de inflexión democrático. Muchas empresas de desarrollo de software, cooperativas agrícolas, despachos jurídicos y compañías de seguros en provincias como Entre Ríos, Santa Fe, Córdoba y Buenos Aires habían frenado la implementación de asistentes inteligentes y sistemas RAG debido a las elevadas cotizaciones en dólares de las bases de datos vectoriales comerciales administradas en la nube.
Con la adopción de motores de código abierto como Qdrant o pgvector optimizados para NVMe, una PyME argentina puede montar su propio motor de búsqueda semántica corporativo sobre un servidor local o una instancia modesta en un proveedor cloud nacional o regional, indexando catálogos comerciales, jurisprudencia, historiales clínicos o manuales técnicos completos con una inversión mensual inferior a los USD 100.
Asimismo, las empresas argentinas proveedoras de servicios tecnológicos tienen la oportunidad de liderar la migración de sistemas anticuados de búsqueda por palabras clave (como Elasticsearch legado) hacia búsqueda híbrida (vectorial + léxica) de alto rendimiento, dotando a clientes de sectores como el agro, la logística portuaria y el retail de capacidades cognitivas de vanguardia con costos plenamente previsibles en moneda local.
5. Hoja de ruta técnica: Checklist de implementación en 4 pasos
- Auditoría de Dimensiones de Embeddings y Volumen de Datos (Paso 1): Evaluar el catálogo de documentos institucionales, seleccionando modelos de embeddings modernos y compactos (como Text-Embedding-3 de OpenAI o BGE-M3 de código abierto) y calculando el volumen proyectado de vectores para dimensionar el almacenamiento necesario.
- Configuración de Cuantización Escalar en el Motor Vectorial (Paso 2): Habilitar las directivas de cuantización escalar (int8) o de producto en bases de datos compatibles (Qdrant, Milvus o pgvector con HNSW), configurando el umbral de almacenamiento en disco para que los vectores se guarden en unidades NVMe rápidas.
- Optimización de Kernel Linux y Sistema de Archivos (Paso 3): Asegurar que los servidores host operen con versiones modernas del kernel Linux (6.1 o superior), formateando los discos NVMe con sistemas de archivos optimizados (XFS o ext4 con soporte Direct I/O) para maximizar el throughput de lectura asíncrona.
- Diseño de Arquitecturas de Datos y Consultoría Especializada (Paso 4): Coordinar el diseño e implementación de su infraestructura de bases de datos para IA y soluciones RAG empresariales con los especialistas de Siglo 21 Soluciones, asegurando máxima precisión de búsqueda al menor costo operativo del mercado.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor