AWS introduce almacenamiento NVMe desagregado para optimizar el rendimiento de bases de datos distribuidas
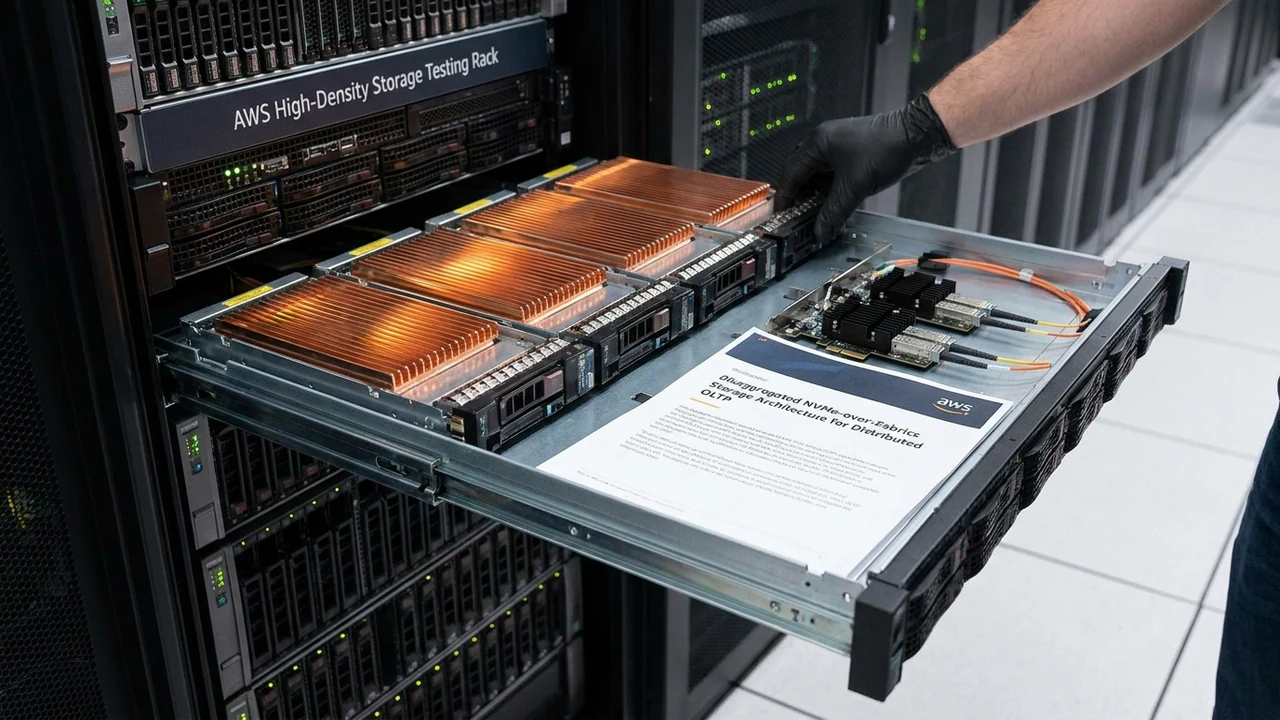
Amazon Web Services (AWS) anunció el lanzamiento comercial de su nueva generación de volúmenes de almacenamiento en bloque desagregado, fundamentados en la especificación NVMe-over-Fabrics (NVMe-oF) y tarjetas aceleradoras Nitro de sexta generación. La nueva arquitectura rompe el compromiso histórico entre persistencia remota y rendimiento de disco local, entregando latencias deterministas de escritura por debajo de los 80 microsegundos y habilitando un salto exponencial de rendimiento para motores de bases de datos distribuidas y procesamiento transaccional en línea (OLTP).
1. Anatomía y contexto de la noticia: El dilema histórico del almacenamiento en la nube
Desde el nacimiento del cómputo en la nube, los arquitectos de datos e ingenieros de infraestructura han enfrentado una disyuntiva constante al diseñar sistemas de alta concurrencia transaccional: elegir entre almacenamiento efímero local (Instance Store) o almacenamiento persistente en red (EBS - Elastic Block Store).
Los discos SSD NVMe conectados directamente al bus PCIe del servidor anfitrión ofrecían un rendimiento extraordinario con cientos de miles de operaciones de entrada/salida por segundo (IOPS) y latencias de microsegundos, ideales para motores de bases de datos exigentes como PostgreSQL, Cassandra, ScyllaDB o MongoDB. Sin embargo, carecían de persistencia: si la máquina virtual sufría una falla de hardware o se detenía, todos los datos contenidos en el volumen se perdían irremediablemente. Por otro lado, los volúmenes en bloque estándar conectados por red ofrecían durabilidad de cinco nueves y copias de seguridad instantáneas, pero introducían latencias variables de entre 1 y 4 milisegundos debido al encapsulamiento TCP/IP tradicional y los saltos de enrutamiento en el centro de datos.
La nueva arquitectura de almacenamiento desagregado presentada por AWS elimina esta barrera tecnológica. Al utilizar un plano de conmutación dedicado de fibra óptica con tecnología EFA (Elastic Fabric Adapter) y protocolos de acceso directo a memoria remota (RDMA), AWS desacopla físicamente los bancos masivos de almacenamiento de estado sólido de los nodos de cómputo, entregando la resiliencia y flexibilidad de la red con la velocidad pura del silicio local.
"Hemos eliminado la penalización de latencia de red en el almacenamiento empresarial. Al desagregar el hardware NVMe a nivel de silicio con Nitro y RDMA, ofrecemos a las bases de datos de misión crítica la velocidad de una unidad local con la durabilidad, redundancia y capacidad de recuperación instantánea de la nube global."
2. Arquitectura técnica profunda y estándares NVMe-over-Fabrics (NVMe-oF)
El salto cualitativo de la nueva plataforma de AWS descansa sobre una profunda reingeniería en la capa física, de transporte y de controladores:
- Protocolo NVMe-oF sobre RoCEv2 (RDMA over Converged Ethernet): A diferencia de las pilas iSCSI tradicionales que obligan al procesador de la máquina virtual a procesar interrupciones de software y empaquetar tramas TCP, NVMe-oF transfiere comandos y datos directamente desde la memoria RAM del servidor de base de datos hacia los controladores SSD remotos sin intervención de la CPU anfitriona (kernel bypass), reduciendo el overhead de latencia en un 85%.
- Descarga de Hardware en Tarjetas Nitro v6: Todo el procesamiento del protocolo de almacenamiento, el cifrado de datos en reposo y en tránsito (AES-XTS-256) y la gestión de cuotas de I/O se ejecutan en microprocesadores ASIC propietarios dentro de las tarjetas aceleradoras AWS Nitro. Esto garantiza que el 100% de los núcleos de CPU de la instancia EC2 estén dedicados a procesar consultas SQL/NoSQL sin sufrir degradación de rendimiento.
- Latencia Determinista y Reducción del Fenómeno Tail Latency: En sistemas transaccionales distribuidos gobernados por algoritmos de consenso (Raft o Paxos), la velocidad de confirmación de un bloque está limitada por el nodo más lento. La arquitectura desagregada minimiza la latencia de cola (percentil 99,9) a menos de 120 microsegundos, evitando congelamientos de transacciones y bloqueos de tablas en clústeres distribuidos globales.
- Aislamiento de Recursos de E/S y Resiliencia Multi-AZ: Los nuevos volúmenes replican de forma síncrona cada operación de escritura a través de múltiples dominios de falla físicos dentro de la misma Zona de Disponibilidad (AZ), asegurando una durabilidad anual del 99,999% ante cortes de energía o fallas imprevistas de controladores de disco.
3. Análisis financiero y FinOps cuantitativo: CapEx vs OpEx, ROI y TCO
La optimización en el rendimiento de entrada y salida repercute de forma directa y positiva en la ecuación económica de los sistemas de bases de datos corporativos:
- Reducción de Sobredimensionamiento de Instancias de Cómputo (OpEx): Con frecuencia, las empresas contratan instancias de cómputo sobredimensionadas (por ejemplo, instancias con 64 vCPUs y 256 GB de RAM) no porque requieran tal capacidad de cómputo, sino únicamente para obtener un mayor ancho de banda EBS asignado por el proveedor cloud. Con volúmenes NVMe desagregados de ultra rendimiento, es posible ejecutar la misma carga de trabajo sobre instancias con la mitad de vCPUs, logrando ahorros directos de entre el 30% y el 45% en la factura de máquinas virtuales.
- Ahorro Masivo en Licenciamiento por Núcleo de Bases de Datos: Motores de bases de datos propietarios como Oracle Database Enterprise Edition o Microsoft SQL Server facturan sus licencias comerciales en función de la cantidad de núcleos físicos o vCPUs asignados. Reducir a la mitad el tamaño de las instancias necesarias gracias a la eliminación del cuello de botella de I/O ahorra cientos de miles de dólares en costos recurrentes de licenciamiento anual de software.
- TCO Global y Retorno de la Inversión (ROI): Aunque el costo por gigabyte de los nuevos volúmenes NVMe-oF presenta una prima marginal de entre un 10% y un 15% sobre los volúmenes SSD estándar (io2 Block Express), la consolidación de hardware y licencias produce un ahorro neto de TCO del 28% en un horizonte a 3 años, con un período de repago inferior a los cuatro meses.
4. Implicancias y oportunidades para empresas y PyMEs de Argentina y América Latina
Para los bancos, billeteras digitales, empresas de retail y operadores logísticos de Argentina y América Latina, el rendimiento de las bases de datos transaccionales representa el núcleo vital de su operación diaria:
Durante eventos comerciales masivos como el Hot Sale o el CyberMonday en Argentina, las plataformas de comercio electrónico y los motores de checkout financiero sufren frecuentemente bloqueos y tiempos de respuesta lentos ocasionados por cuellos de botella en la escritura de los registros de transacciones (WAL - Write-Ahead Logging). Implementar almacenamiento NVMe desagregado permite a las empresas locales multiplicar por diez la capacidad de procesamiento de órdenes simultáneas sin necesidad de rediseñar por completo la arquitectura de software de sus bases de datos.
Asimismo, para las empresas que operan infraestructuras híbridas entre centros de datos locales y la nube, la posibilidad de disponer de rendimiento de disco local sin perder la capacidad de realizar instantáneas (snapshots) consistentes y migraciones en caliente simplifica enormemente los planes de continuidad del negocio y recuperación ante desastres (DRP).
5. Hoja de ruta técnica: Checklist de implementación en 4 pasos
- Identificación de Cuellos de Botella de E/S y Diagnóstico de Métricas (Semana 1-2): Auditar las bases de datos corporativas utilizando herramientas de monitoreo como pg_stat_activity, sys.dm_os_wait_stats o AWS Performance Insights. Identificar esperas por I/O de disco (PAGEIOLATCH, wal_sync) que superen el 15% del tiempo total de procesamiento de consultas.
- Pruebas de Concepto con Instancias Compatibles con Nitro v6 (Semana 3-4): Configurar un entorno de pruebas réplica utilizando tipos de instancias EC2 modernas con soporte EFA y Nitro v6. Acoplar los nuevos volúmenes NVMe desagregados y ejecutar bancos de pruebas sintéticos estandarizados (con herramientas como Sysbench o pgbench) para calibrar ganancias de latencia y rendimiento de transacciones por segundo (TPS).
- Ajuste de Parámetros del Motor de Base de Datos y Memoria Compartida (Semana 5-6):
Ajustar los parámetros de configuración de la base de datos para aprovechar la menor latencia de disco (por ejemplo, reducir
max_wal_size, optimizarcheckpoint_completion_targeten PostgreSQL y adecuar la frecuencia de confirmación de transacciones en motores NoSQL). - Migración en Caliente y Certificación de Rendimiento Continuo (Semana 7-8): Ejecutar la migración de volúmenes de producción aprovechando la capacidad de replicación y cambio de tipo de volumen sin tiempo de inactividad de AWS. Respaldar la optimización de almacenamiento y la gobernanza de bases de datos con el soporte de consultores senior de Siglo 21 Soluciones para asegurar estabilidad, rendimiento máximo y costos eficientes en toda la arquitectura.
Fuentes & Referencias Verificadas
¿Querés implementar estas tecnologías en tu empresa?
En Siglo 21 Soluciones te asesoramos e implementamos software a medida, inteligencia artificial y ciberdefensa.
Contactar a un Consultor